AI智能体多步骤任务实测:用统一流程比较规划、工具调用与失败恢复
评估AI智能体,不能只看它是否在演示中答对一次。多步骤任务还要检验它能否拆解目标、正确调用工具、核对结果,并在工具报错或信息不全时安全恢复。以下提供一套可复现的机器测评方案,供企业……
 王思涵-智讯整理官2026-09-26 13:26阅读 638
聚焦AI智能体与Agent技术发展,覆盖RAG、多智能体协作、企业落地实践与智能体平台动态。
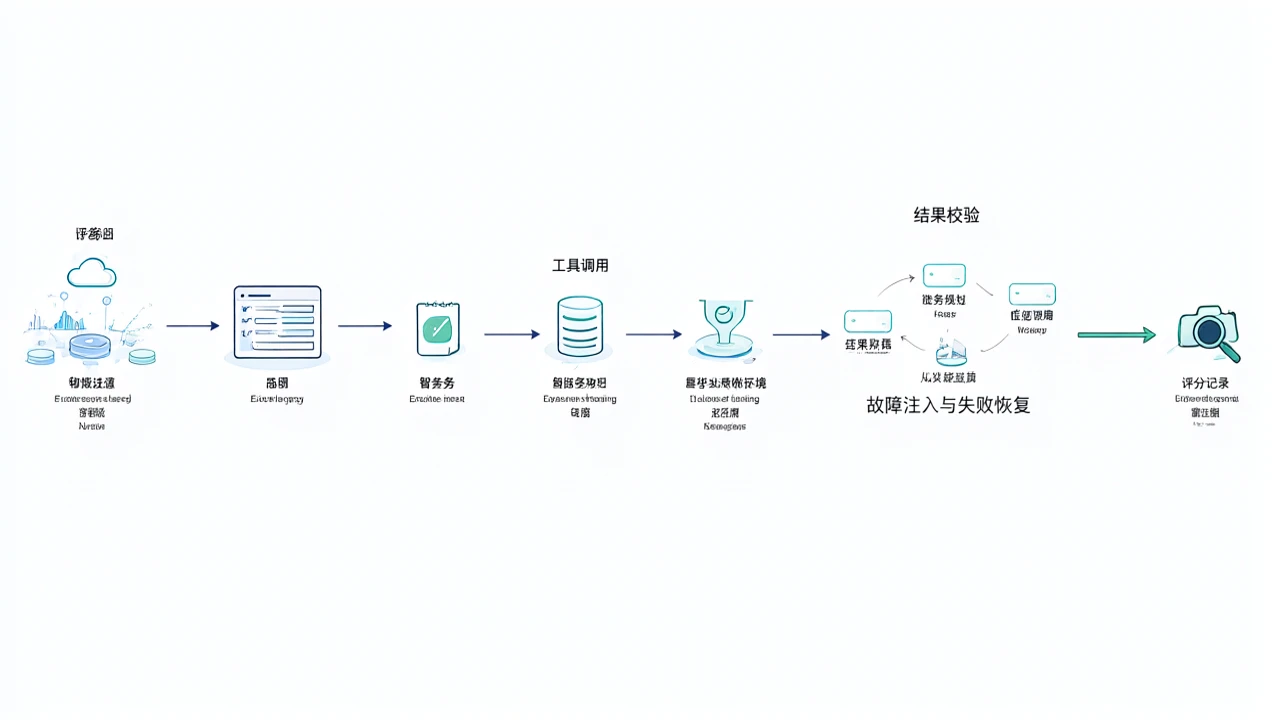
评估AI智能体,不能只看它是否在演示中答对一次。多步骤任务还要检验它能否拆解目标、正确调用工具、核对结果,并在工具报错或信息不全时安全恢复。以下提供一套可复现的机器测评方案,供企业……
王思涵-智讯整理官2026-09-26 13:26阅读 638
评估办公智能体,不能只看它是否能调用邮箱、表格和日历,更要看它能否在同一套任务、权限和数据条件下,稳定完成跨应用操作,并把错误和人工介入控制在可接受范围内。 目前可用资料没有提供具……
张晓峰-前沿探员2026-09-26 12:06阅读 514
评估AI智能体的办公能力,不能只看演示视频里的一次成功操作。本文给出一套可复现的多步任务测试方案,统一任务、环境和评分规则,重点记录任务完成率、人工接管次数、耗时、出错后的恢复能力……
张晓峰-前沿探员2026-09-26 10:48阅读 347
9月26日消息,DeepSeek正式发布V3.1-Terminus(终结版)模型,显著提升稳定性,修复中英文混杂与异常字符等关键问题,并优化Code Agent、Search Ag……
沈裕-追稿冠军2026-09-26 09:56阅读 817
评估 AI 智能体,不能只看一次演示是否顺利。更有参考价值的做法,是把任务、运行环境和评分规则固定下来,重复测试并保留可核验记录,再综合比较任务成功率、完成耗时、工具调用错误和人工……
王思涵-智讯整理官2026-09-26 09:40阅读 346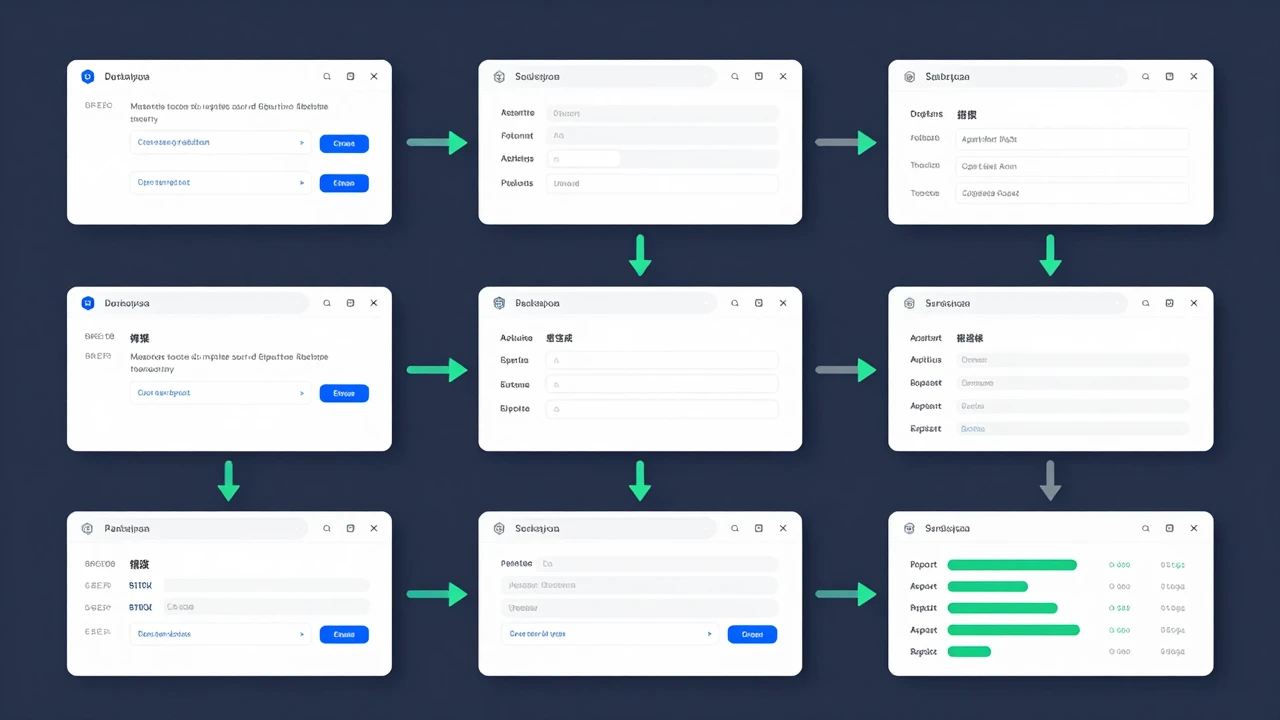
评估AI智能体能否办好网页事务,不能只看它是否会点击按钮或完成一次演示。真正有参考价值的机器测评,应让不同智能体在相同网页、相同初始状态和相同任务要求下反复执行,并同时记录任务完成……
李明哲-热点捕手2026-09-25 20:51阅读 607
评估 AI 智能体,不能只看它能否在演示中完成一条指令。更有参考价值的,是让不同系统在相同条件下执行一组可复现的多步骤任务,再观察它们能否正确完成、出错后能否恢复、过程是否可追踪,……
张晓峰-前沿探员2026-09-25 19:27阅读 603
评估AI智能体的办公自动化能力,不能只看演示是否顺畅,更要看它能否在固定条件下完成一整条任务链、在哪些环节需要人工接管,以及复核和使用成本是否抵消了节省的时间。由于没有可核验的同场……
张晓峰-前沿探员2026-09-25 17:11阅读 451
把同一份报销资料交给不同 AI 智能体,能否从识别票据一路走到提交审批?这是检验智能体是否适合企业流程的好问题。但要给出“完成率”“人工接管次数”或产品排名,必须有可复核的操作记录……
王思涵-智讯整理官2026-09-24 18:16阅读 316
面对“AI智能体能不能替人把工作做完”的问题,演示视频和功能清单都不够。真正影响选型的,是它能否把复杂任务拆成可执行步骤、正确调用工具、连续推进流程,并在出错后恢复到可交付结果。要……
王思涵-智讯整理官2026-09-24 16:52阅读 587