企业级应用
-
上海AI实验室发布InternLumina-U2:统一多模态模型为何把文本、图像、视频与3D纳入同一框架?
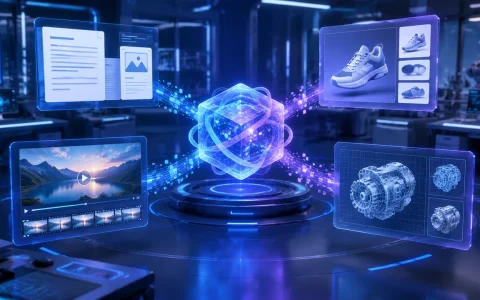
上海人工智能实验室发布InternLumina-U2,尝试将文本、图像、视频与3D纳入同一框架,以多码本扩散架构和约160亿参数MoE模型支撑统一处理,单次推理激活参数约10亿。它或可减少多模型串联,服务内容生产、客服、工业视觉和数字孪生,但公开评测仍是初步、部分结果,企业究竟该如何验证其真实能力与部署成本?
-
9月7日:Moonshot发布2.8万亿参数开源模型Kimi K3,科大讯飞同步推出星火X2.5大模型
企业在部署大模型时常受算力高成本、长文本处理和跨模态集成的瓶颈困扰。2.8万亿参数Kimi K3凭借MoE稀疏激活和1 百万token上下文窗口实现本地低成本推理并支持原生视觉,科大讯飞星火X2.5提供扩展上下文和API服务,帮助企业合规快速落地。面对这两种截然不同的选型路径,哪种模型更符合你的业务需求?
-
AI产业新闻频繁谈“能不能干活”,企业该如何计算有效产出成本?
【软盟资讯·新闻导读】AI产业的竞争重点正在从模型“会不会生成”,转向系统“能不能持续完成工作”。企业评估AI项目时,不能只看模型调用单价,还要核算部署稳定性、流程改造、合规校验和人工兜底等实际成本。 AI产业新闻近来频繁出现一个变化:讨论…
-
从韩国企业部署到芯片研发,OpenAI与三星合作释放了什么产业信号?
【软盟资讯·新闻导读】9月9日,OpenAI宣布深化与三星电子的合作:一方面扩大ChatGPT等企业级软件在三星内部的应用,另一方面推进下一代定制AI芯片的联合研发与生产。两条线索分别连接应用落地与底层基础设施,显示AI竞争正从模型能力延伸…
-
模型更便宜、智能体更强只是二级资料判断:企业该如何核验AI更新价值?
围绕Claude Fable 5.1成本下降与AutomationBench表现提升的说法,文章提醒企业将其视为二级资料线索,不能直接作为采购依据。核验时应拆分缓存命中与真实总成本,并用脱敏业务任务测试调用量、延迟、稳定性和任务成功率,综合评估模型价值。
-
把规范和手册带到施工现场:建筑类AI应用为何更依赖可信信息而非聊天能力?
建筑类AI应用的核心价值正从通用聊天能力转向可信资料的调用。在施工现场,AI需精准检索建筑规范、制造商手册及公司政策,并提供可核验的依据以确保责任追溯。企业采购应重点评估资料连接、检索质量及权限管理,而非仅关注模型参数或语言流畅度。
-
NavigateAI获2500万美元种子轮融资,建筑工地副驾驶为何成为AI应用新场景?
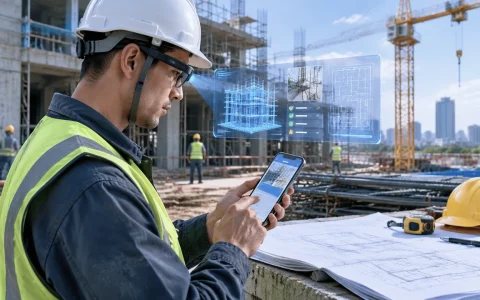
NavigateAI获2500万美元种子轮融资,计划通过智能手机和Meta AI眼镜,为建筑工人提供免手操作的实时AI副驾驶,将建筑规范、企业政策与现场指导嵌入施工流程。文章分析其垂直AI价值及数据治理、可靠性和商业化验证挑战。
-
OpenAI企业业务单月增长32%:AI商业化为何从个人订阅转向企业工作流?
OpenAI企业业务7月环比增长32%,收入占比已超四成,商业重心正从个人订阅转向企业工作流。这表明AI付费单位正向组织流程转移,竞争核心由模型能力转向企业落地能力。企业采购更看重AI与现有流程的集成及实际效率提升,而非单纯的模型性能。
-
GUI自动化被认为将进入企业级阶段:安全与合规会成为落地门槛
GUI自动化正从固定规则和录制重放走向能理解界面、动态调整步骤的智能体;企业落地的关键不只是“能操作”,还包括分级授权、人工确认、全程审计和风险边界。未来六个月出现成熟安全合规产品仍属预测,企业应先验证权限、留痕与异常中止能力。
-
多模态模型降价加速应用落地:企业试点应先选择哪些任务
多模态模型降价降低了企业试点门槛,但首轮应用不宜盲目追求自动化,应优先选择输入明确、结果可核验且人工可兜底的任务,如结构化信息提取、内容分类、视觉质检和短音视频整理,并通过真实样本验收稳定性,综合评估调用、审核与返工成本。
-
Perplexity本地Agent采用阿里Qwen3.8-27B:中国开源模型为何走向海外应用
Perplexity推出本地Agent Portable Computer,采用阿里开源模型Qwen3.8-27B,面向文件处理、数据分析和编程。文章指出,本地部署强化数据控制与任务执行,中国开源模型通过海外产品落地,但性能和兼容范围仍待验证。
-
千问办公多人工作台与星火X2.5同日出现:办公AI竞争开始转向协作与模型升级
千问办公多人工作台与科大讯飞星火X2.5同日出现,分别代表办公AI从个人工具走向多人协作入口,以及模型在代码、智能体和长上下文等能力上的升级。企业评估不能只看参数或界面,还需结合任务、流程、稳定性与实际场景判断价值。