多模态大模型
-
上海AI实验室发布InternLumina-U2:统一多模态模型为何把文本、图像、视频与3D纳入同一框架?
上海人工智能实验室发布InternLumina-U2,尝试将文本、图像、视频与3D纳入同一框架,以多码本扩散架构和约160亿参数MoE模型支撑统一处理,单次推理激活参数约10亿。它或可减少多模型串联,服务内容生产、客服、工业视觉和数字孪生,但公开评测仍是初步、部分结果,企业究竟该如何验证其真实能力与部署成本?
-
DeepSeek V4.1 Flash发布:原生视觉、MoE与KV缓存如何影响企业模型选型
DeepSeek V4.1 Flash采用原生视觉与MoE架构,输入、输出阶段分别激活约80亿和160亿参数,并以较小KV缓存支持长上下文与高并发。企业选型不能只看5520亿总参数,还应综合权重显存、专家通信、视觉输入、缓存管理及端到端成本,在目标硬件和业务负载下实测。
-
ADSE2026六大核心展区就位,全维进化启幕
ADSE2026六大核心展区就位,全维进化启幕 北京AI数字科技智慧医疗展(ADSE)六大核心展区全部规划就位,AI智慧医疗产业全维进化正式启幕。展会定于2027年6月26-28日在北京亦创国际会展中心举办,展览面积3.5万㎡…
-
DeepSeek V4.1 Flash开启限量测试:新架构与原生多模态将如何改变模型选型?
DeepSeek启动V4.1 Flash限时内测,该版本采用新架构并原生支持多模态,旨在提升能力与速度并降低成本。正式版预计9月10日前后发布,届时将实施峰谷分时计费。过渡期内V4 Pro请求将路由至此版本并按Flash价格计费。
-
智谱发布GLM-5.3-Flash:320B多模态模型为何把价格降到上一代十分之一?
智谱推出GLM-5.3-Flash,保持320B总参数,激活仅18B,层数45层并采用稀疏线性混合注意力,使推理成本降至前代十分之一(输入0.15美元/百万Token,输出0.50美元),支持视觉,适用于前端、游戏和3D仿真等场景。
-
大模型竞争从参数规模转向效率:GLM-5.3-Flash释放了什么产品信号
GLM-5.3-Flash以320B总参数、18B激活参数和混合注意力架构,体现大模型竞争由参数规模转向推理效率、长上下文成本与部署可行性。其原生多模态、开源及适配信息,为企业评估智能体、编程和自动化场景时同步衡量能力、成本与交付能力提供样本。
-
智谱GLM-5.3-Flash亮相:320B多模态模型降价后,开发者如何评估智能体调用成本
智谱GLM-5.3-Flash以320B总参数、18B激活参数和原生多模态能力开放API,价格下探不等于智能体总成本降低。团队应基于真实任务,统筹上下文、工具调用、重试与人工介入,按成功任务评估端到端成本和稳定性。
-
GPT-6 Astra 9月6日正式上线:企业级智能体功能全解析
GPT-6 Astra于9月6日前后分阶段上线,覆盖ChatGPT Work、Codex和API,核心从问答转向跨页面、跨工具完成任务。其支持文本与图像输入、105万token上下文,并提供企业智能体能力;企业仍需评估成本、权限、审批、数据安全和人工复核。
-
2027赛逸展:海外企业借展会落地中国市场
本届赛逸展总展览规模3.5万㎡,定向甄选395家优质科创企业参展,汇聚2.6万名付费专业观众,集结10支海外采购团与5家国际财团,打造国际化、专业化、市场化的产业对接平台。展会依托北京亦庄顶尖的科创产业集群优势,联动本地三百余家产业链企业,为海外品牌落地中国提供全方位生态支撑。
-
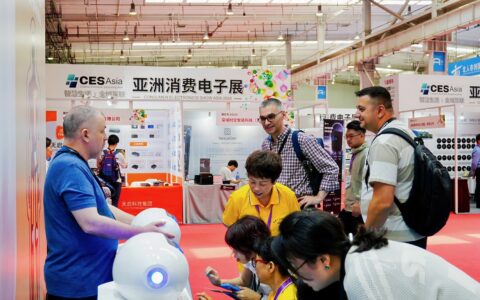
倒计时开启 CEE2026北京国际消费电子博览会展位抢订中
距离CEE2026北京国际消费电子博览会开幕日益临近,展会各项筹备工作正在有序推进,展位预订已进入关键阶段。本届展会定于11月12日至14日在北京亦创国际会展中心举办,聚焦消费电子、智能硬件、智能家居、机器人、V…
-
GPT-6 Astra的多模态能力将如何重塑企业应用
OpenAI发布GPT-6 Astra,将文本与图像输入统一接入任务执行链路,可生成文档、表格、演示文稿及代码。OSWorld 2.0完成准确率72.6%,任务耗时较上代缩短约47%。企业可优先探索文档批量生产、图像理解入流程及长任务代码辅助,但需权衡数据接入成本、安全边界与任务可靠性。
-
从“看懂人”到“行动如人”,Human-Centric AI为何成为基础模型新焦点
从“看懂人”到“行动如人”,Human-Centric AI正成为基础模型研究新焦点。研究路径可拆为外观感知、空间几何与行动推理三层,强调对人的连续状态建模,而非孤立任务堆叠,推动模型从识别转向理解与交互。