芯片设计智能体为何可能采用小模型:任务拆分与验证要点
针对芯片设计智能体,小型语言 大模型 的价值不在于“替代更大的模型”,而在于为边界清楚、输入输出可约束的任务提供另一种架构选择。是否适用,取决于任务拆分是否合理、模型能力是否与工具……
 张晓峰-前沿探员2026-10-02 12:13阅读 468
标签"工具调用"下的所有文章
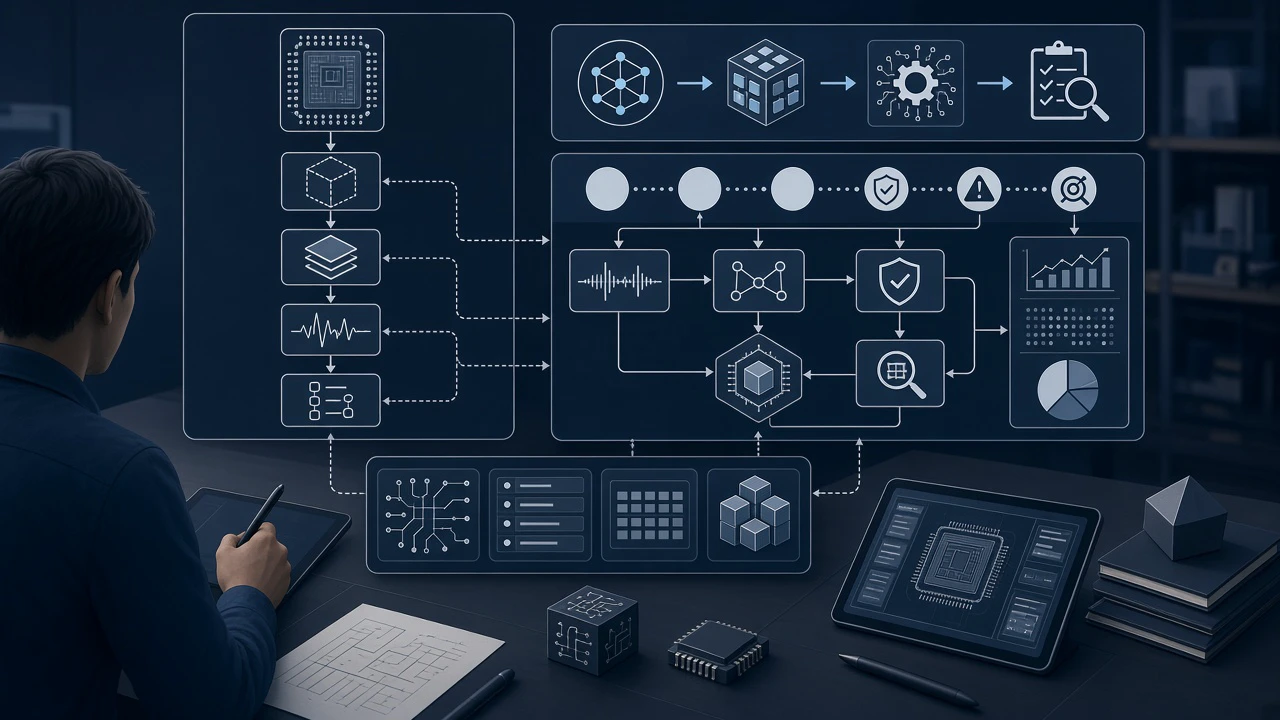
针对芯片设计智能体,小型语言 大模型 的价值不在于“替代更大的模型”,而在于为边界清楚、输入输出可约束的任务提供另一种架构选择。是否适用,取决于任务拆分是否合理、模型能力是否与工具……
张晓峰-前沿探员2026-10-02 12:13阅读 468
企业评估 AI 智能体,单次演示能否顺利完成任务,并不能说明它适合接入真实流程。更有参考价值的机器测评,是固定任务、数据、工具和权限,让智能体多次执行一条包含网页检索、表格整理与邮……
李明哲-热点捕手2026-09-28 15:22阅读 556
评估AI智能体,单看一次演示成功,往往看不出它能否持续完成一条长流程。更有参考价值的做法,是把相同任务、数据、工具权限和故障条件交给不同智能体,逐步记录它们如何规划、调用工具、处理……
李明哲-热点捕手2026-09-28 12:56阅读 556
AI智能体的单轮演示,往往只展示“能不能做”,却难以回答它能否在真实工作流中持续完成多个相互依赖的步骤。评估长流程任务时,与其比较几段成功案例,不如在相同条件下重复执行可复现的任务……
李明哲-热点捕手2026-09-27 20:45阅读 533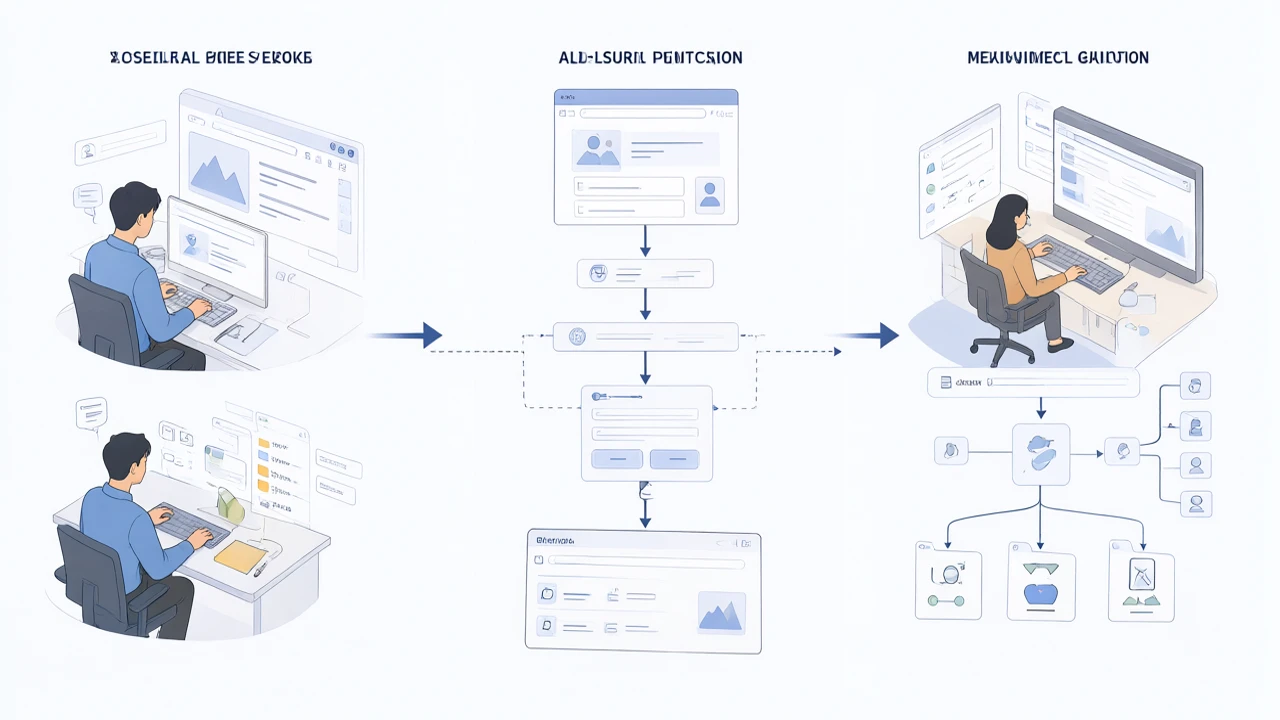
浏览器操作型AI智能体能否独立完成网页检索、表单填写,并在页面出错时稳妥恢复,不能只看演示视频。可靠的实测对比需要让候选产品执行同一组任务,并统一成功判定、测试环境和记录口径。由于……
张晓峰-前沿探员2026-09-27 14:21阅读 440
跨应用任务是检验AI智能体是否能真正执行工作的关键场景,但演示视频和厂商公布的单项成绩,不能替代同条件复测。本文给出一套可重复的测试方案。由于目前没有具体参测产品、运行记录和原始日……
王思涵-智讯整理官2026-09-27 13:02阅读 265
评估AI智能体的网页资料整理能力,关键不是看演示时能否流畅地打开网页,而是让多个智能体在同一任务、同一资料和同一权限条件下完成闭环,并分别记录结果质量、过程可靠性与安全边界。当前没……
王思涵-智讯整理官2026-09-27 11:51阅读 331
评估 AI 智能体,演示视频里的“一句话办完”并不足以说明它能在企业里稳定工作。真正有区分度的,是同一项任务能否跨应用完成、结果是否准确、遇到权限或工具故障时能否恢复。没有统一环境……
张晓峰-前沿探员2026-09-27 10:50阅读 323
评估AI智能体是否适合进入真实流程,不能只看它能否完成一次漂亮的演示。更有区分度的测试,是让它在受控环境中连续完成网页检索、表格整理和邮件草拟,并观察任务是否闭环、遇到问题能否恢复……
张晓峰-前沿探员2026-09-26 19:56阅读 247
评估办公智能体,不能只看它在演示中能否顺利完成一次操作,更要看同一组任务反复运行时,结果是否可靠、出错后能否恢复,以及它是否遵守权限边界。下面提供一套可复现的多步骤办公任务实测方案……
李明哲-热点捕手2026-09-26 18:50阅读 299