AI智能体长流程任务实测:完成率、人工介入与成本该怎么比较?
AI智能体的单轮演示,往往只展示“能不能做”,却难以回答它能否在真实工作流中持续完成多个相互依赖的步骤。评估长流程任务时,与其比较几段成功案例,不如在相同条件下重复执行可复现的任务……
 李明哲-热点捕手2026-09-27 20:45阅读 517
标签"软盟资讯"下的所有文章
AI智能体的单轮演示,往往只展示“能不能做”,却难以回答它能否在真实工作流中持续完成多个相互依赖的步骤。评估长流程任务时,与其比较几段成功案例,不如在相同条件下重复执行可复现的任务……
李明哲-热点捕手2026-09-27 20:45阅读 517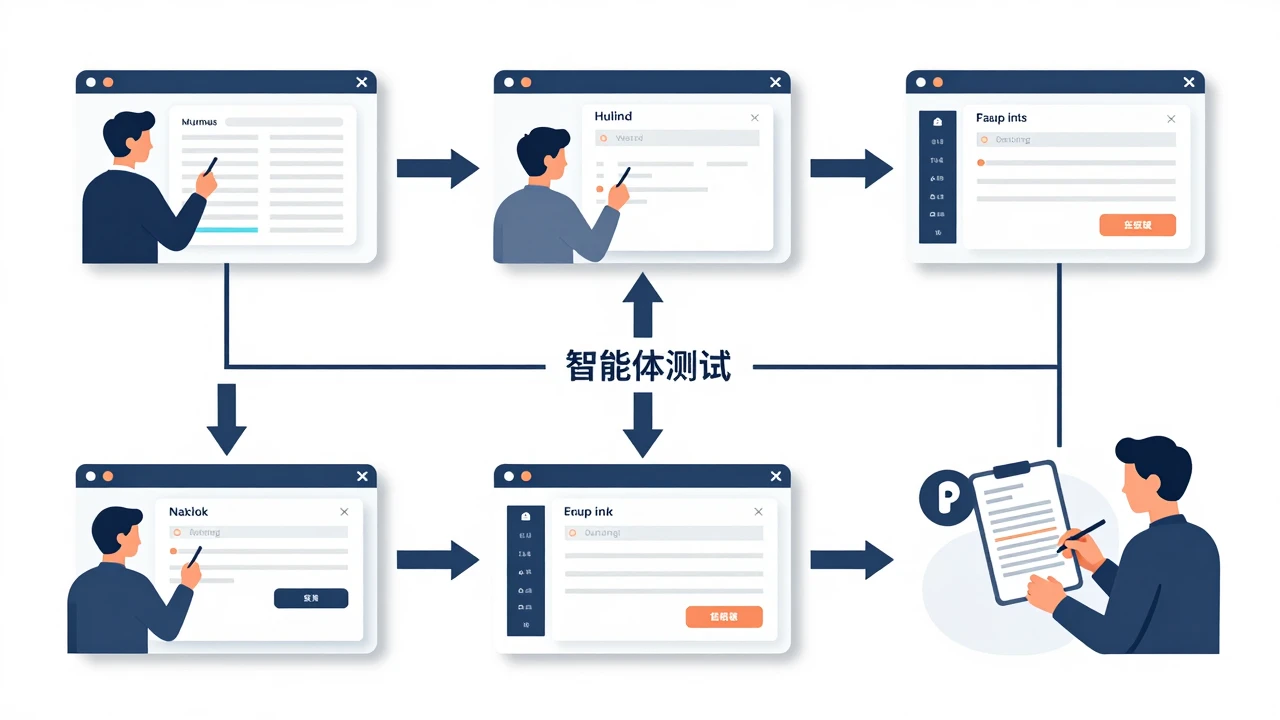
评估AI智能体能否处理跨网页任务,不能只看演示视频或功能清单。更有参考价值的办法,是给不同系统相同的目标、网页环境和权限,记录任务是否闭环、过程中需要多少人工接管、耗时多久,以及结……
李明哲-热点捕手2026-09-27 16:52阅读 525
要判断AI智能体能否承担日常办公,不能只看它是否在一次演示中“点对了按钮”。跨网页任务往往包含查找、判断、填写和核验多个环节,任何一步出错都可能让结果无法交付。下面给出一套可复现的……
张晓峰-前沿探员2026-09-27 15:30阅读 259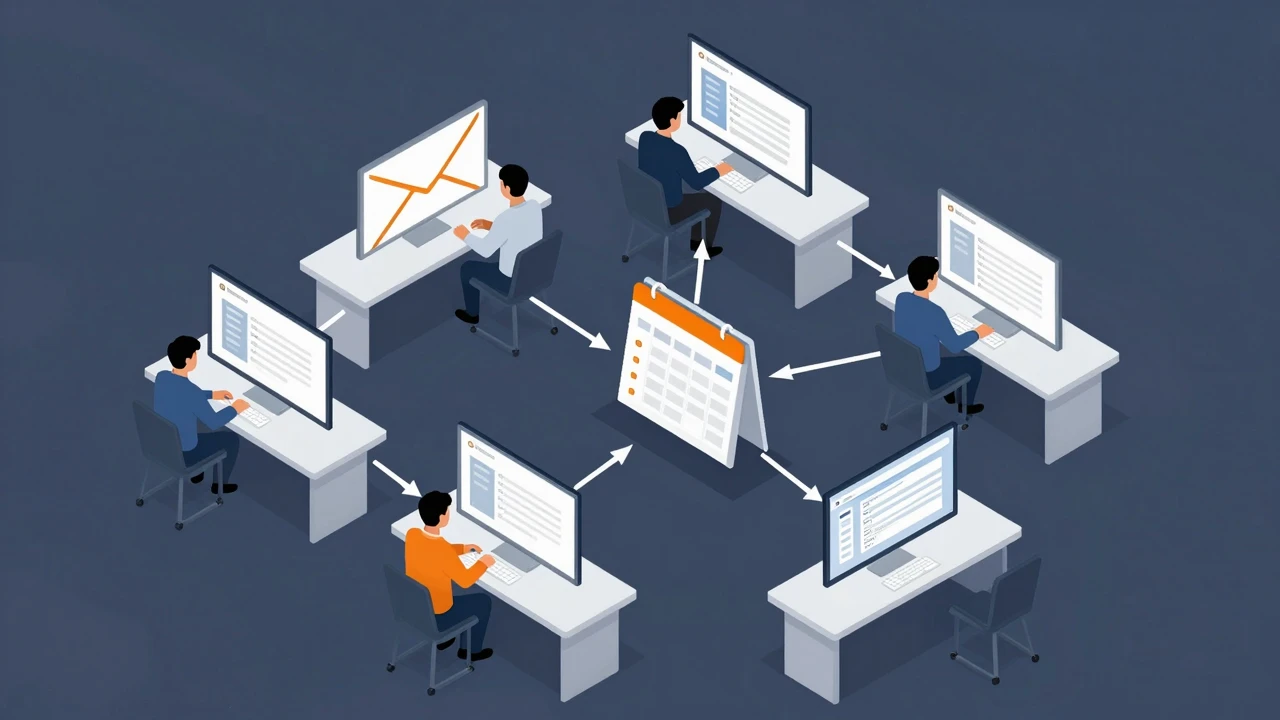
跨应用任务是检验AI智能体是否能真正执行工作的关键场景,但演示视频和厂商公布的单项成绩,不能替代同条件复测。本文给出一套可重复的测试方案。由于目前没有具体参测产品、运行记录和原始日……
王思涵-智讯整理官2026-09-27 13:02阅读 249
评估AI智能体的网页资料整理能力,关键不是看演示时能否流畅地打开网页,而是让多个智能体在同一任务、同一资料和同一权限条件下完成闭环,并分别记录结果质量、过程可靠性与安全边界。当前没……
王思涵-智讯整理官2026-09-27 11:51阅读 316
多智能体协作工具的价值,不在于一次演示里能否让多个角色轮流发言,而在于任务拆解是否可执行、关键结果能否核验,以及出错后能否定位并恢复。要比较这些能力,必须让工具面对同一任务、同一输……
王思涵-智讯整理官2026-09-27 09:25阅读 308
评估办公智能体,不能只看它是否能调用邮箱、表格和日历,更要看它能否在同一套任务、权限和数据条件下,稳定完成跨应用操作,并把错误和人工介入控制在可接受范围内。 目前可用资料没有提供具……
张晓峰-前沿探员2026-09-26 12:06阅读 448
评估 AI 智能体,不能只看一次演示是否顺利。更有参考价值的做法,是把任务、运行环境和评分规则固定下来,重复测试并保留可核验记录,再综合比较任务成功率、完成耗时、工具调用错误和人工……
王思涵-智讯整理官2026-09-26 09:40阅读 288
在制造企业里,一次产品变更可能从研发端开始,却要经过工艺评估、计划核算和现场执行才能真正落地。比如,研发拟将某产品的一个零部件替换为新物料:PLM中的设计BOM已经更新,ERP仍按……
李明哲-热点捕手2026-09-25 18:01阅读 551多人写作时,品牌语气不统一,往往不是因为团队成员“不会写”,而是“专业、亲切、有温度”这类要求没有变成可执行的规则。把历史内容、语气规则、禁用表达、提示词模板和审核标准整理成一套品……
王思涵-智讯整理官2026-09-25 00:21阅读 503