【软盟资讯·新闻导读】日本新闻协会于2025年6月4日发布声明,明确要求生成式AI企业在使用新闻内容进行模型训练或提供服务时,必须尊重由robots.txt等技术措施所传达的权利人意愿,并在使用前获得许可。该声明特别指出,即便现行日本著作权法未明确禁止AI的“无断学习”,但无视技术措施抓取数据的行为可能构成“不当损害著作权人利益”。这为正在构建或采购RAG等AI产品的企业划出了一条清晰的合规红线:数据能否被抓取与生成结果能否被使用,是两个必须分别审视的法律问题。
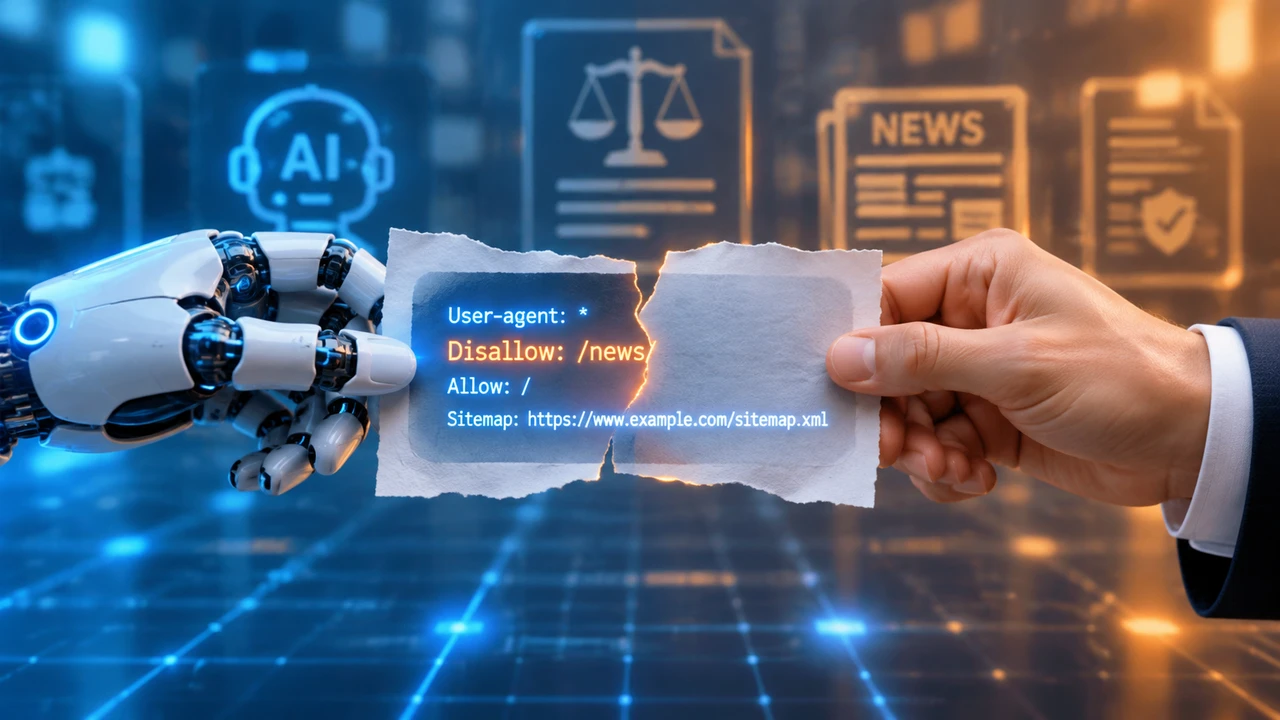
长期以来,日本新闻协会一直呼吁生成式AI服务在学习和利用报道内容时,必须获得著作权人的许可。然而,由于内容保护的规则长期不完善,该协会在最新的声明中将目光聚焦于一个具体且操作性强的技术协议——robots.txt。声明认为,网站通过robots.txt设置访问限制,是权利人表达“拒绝被用于AI训练”意愿最高效、最明确的方式,同时对于数据采集方而言,遵循这一指示也几乎不增加额外成本。因此,协会强调,AI开发者、服务提供商及数据采集者尊重这一技术信号是理所当然的,如果需要使用新闻内容进行训练或生成回答,获得权利人许可是基本前提。
技术指示与法律风险的分野:抓取不等于可用
当前,许多企业正在基于检索增强生成(RAG)技术构建AI应用。一个常见的误区是将“数据能否被抓取”与“生成结果能否被使用”混为一谈。日本新闻协会的声明恰好点明了这其中的关键差异。
robots.txt本质上是一个技术层面的“君子协议”,它不具有直接的法律约束力,但它传达了权利人明确的意愿。日本文化厅在2024年3月发布的《关于AI与著作权的思考》中明确指出,如果为了AI学习而故意规避网站的技术保护措施(如无视robots.txt)去收集数据,且该数据是作为数据库作品进行销售或可推定为准备销售的,那么这种行为可能构成日本著作权法第30条之4但书条款中“不当损害著作权人利益”的情形,从而构成侵权。
而对于RAG服务,风险链条更长。文化厅的“思考”文件认为,当RAG生成的回答超出了著作权法第47条之5规定的“轻微利用”范畴,实质性地再现了原始作品时,就必须获得著作权人的许可。这意味着,即使企业通过合法或灰色手段获取了数据用于构建RAG知识库,最终呈现给用户的答案一旦“复述”了新闻的核心表达,依然会触发版权风险。
企业核验与风控的四步清单
对于互联网创业者和AI产品负责人而言,面对日益复杂的全球监管环境,建立一套可落地的合规审查机制至关重要。结合日本的最新声明和全球趋势,企业可以从以下四个环节着手:
第一,数据来源核验与授权状态记录。 在采购或抓取任何新闻类数据前,必须检查目标网站的robots.txt文件。如果网站明确禁止特定AI爬虫(例如GPTBot、CCBot等),或设置了“Disallow: /”的规则,则应将其视为“权利人明确拒绝”的信号。同时,建立数据来源台账,记录每批训练数据或RAG知识库内容的原始URL、爬取时间、robots.txt状态以及是否获得书面授权。
第二,模型训练阶段的版权清单。 如果企业使用第三方预训练模型或API,需向供应商核实其训练数据的合规性,尤其是是否包含来自日本、欧盟等严格监管地区的新闻数据。对于自研模型,务必确保训练数据集中不包含来自明确声明“禁止AI学习”的新闻网站的数据。欧盟的《AI法案》和美国的部分州立法也对训练数据透明度提出了要求,企业需针对不同市场采取差异化的合规策略。
第三,RAG检索与回答呈现的边界控制。 这是风险的高发区。企业应在RAG系统的检索环节加入过滤机制,对来自robots.txt明确禁止抓取的网站内容进行标记或排除。在生成回答的环节,应设计提示词或后处理逻辑,避免直接“复制粘贴”或“摘要式复述”原文的核心表达。可以设置“引用来源”的强制模块,并定期评估生成内容与原始新闻的相似度。
第四,建立退出机制与人工复核。 为权利方提供便捷的“退出”通道,例如,当新闻机构更新其robots.txt或发送正式通知要求删除其内容时,企业应有能力在合理时间内(例如48小时)完成数据清理和模型或知识库的更新。对于高风险领域(如时事政治、财经报道)的AI生成内容,应建立人工复核抽样机制,确保不因AI的“忠实复述”而引发直接侵权。
不同法域的规则差异与全球趋势
日本新闻协会的声明并非孤立事件,它反映了全球范围内对生成式AI与版权冲突的普遍关切,但不同法域的规则侧重点和严格程度存在差异。
欧盟的《AI法案》侧重于风险分级,对高风险AI系统的训练数据透明度提出了严格披露要求,但并未直接规定robots.txt的法律效力。美国的版权局和法院则通过“合理使用”原则进行个案判断,目前已有多个针对AI公司未经授权使用新闻内容的集体诉讼,结果尚在博弈中。而日本此次的动向,结合文化厅的“思考”文件,实际上是通过政府指导文件,将“尊重技术措施”这一行业惯例,向“法律义务”的方向推进了一大步。
对于面向全球市场的企业来说,最稳妥的策略不是去钻某一法规的空子,而是采取“最高标准”的合规策略:即尊重所有来源的robots.txt,对所有新闻类数据均取得明确授权,并严格限制RAG输出对原始内容的再现。
【软盟观察】日本新闻协会此次声明的核心价值,在于它为企业提供了一个从“技术信号”到“法律后果”的清晰推演路径。过去,很多创业者在搭建AI应用时,往往默认互联网上的公开数据就是“可自由取用”的。这份声明连同文化厅的“思考”文件,打破了这种认知惯性,它明确指出:robots.txt不仅是技术参数,更是权利人“禁止”的法律信号;RAG生成的结果,也不是简单的信息聚合,而是可能构成对原始作品的“利用”。
对于企业决策者而言,这意味着必须将“数据合规”从后台的法务文档,前置到产品架构设计阶段。具体到行动层面,我们建议:第一,立即将“robots.txt合规检查”纳入数据采集团队的SOP,并建立定期复核机制,因为新闻网站的robots.txt策略会动态更新。第二,在采购或自建RAG服务时,优先选择那些明确获得新闻机构授权、或仅使用开源/自有无版权数据的供应商。第三,对于任何涉及新闻、时事、财经等强版权属性的内容,建议采用“摘要+原文链接”而非“内容生成”的模式,将风险转移至用户点击行为。
未来的AI竞争,不仅是算法和算力的竞争,更是合规能力的竞争。谁能在数据使用边界上做到清晰、透明、可追溯,谁就能在长期竞争中赢得版权方的信任和监管层的认可。
相关话题
关于文章版权的声明:
https://news.softunis.com/76157.html 文章来自软盟资讯
若非本站原创的文章,特别作如下声明:
本文刊载所有内容仅供提供信息交流和业务探讨而非提供法律建议目的使用,不代表任何监管机构的立场和观点。不承担任何由于内容的合法性及真实性所引起的争议和法律责任。
凡注明为其他媒体来源的信息,均为转载,版权归版权所有人所有。
如有未注明作者及出处的文章和资料等素材,请版权所有者联系我们,我们将及时补上或者删除,共同建设自媒体信息平台,感谢你的支持!