


一次请求超时,不等于服务端没有执行:客户端可能没收到响应,而服务端已经完成了写入。此时盲目重试,可能把一次业务操作变成两次;如果大量客户端同时重试,又会在服务最脆弱时增加负载。设计的关键不是“尽量重试”,而是让同一业务意图重复到达时结果可控,并限制重试对系统的放大效应。
先分清:超时、失败与重复执行
请求经过客户端、网络、网关和服务端,响应还要沿原路返回。超时可能发生在任一环节。客户端看到超时,只能确认“没有按时拿到结果”,不能据此判断服务端是否处理成功。
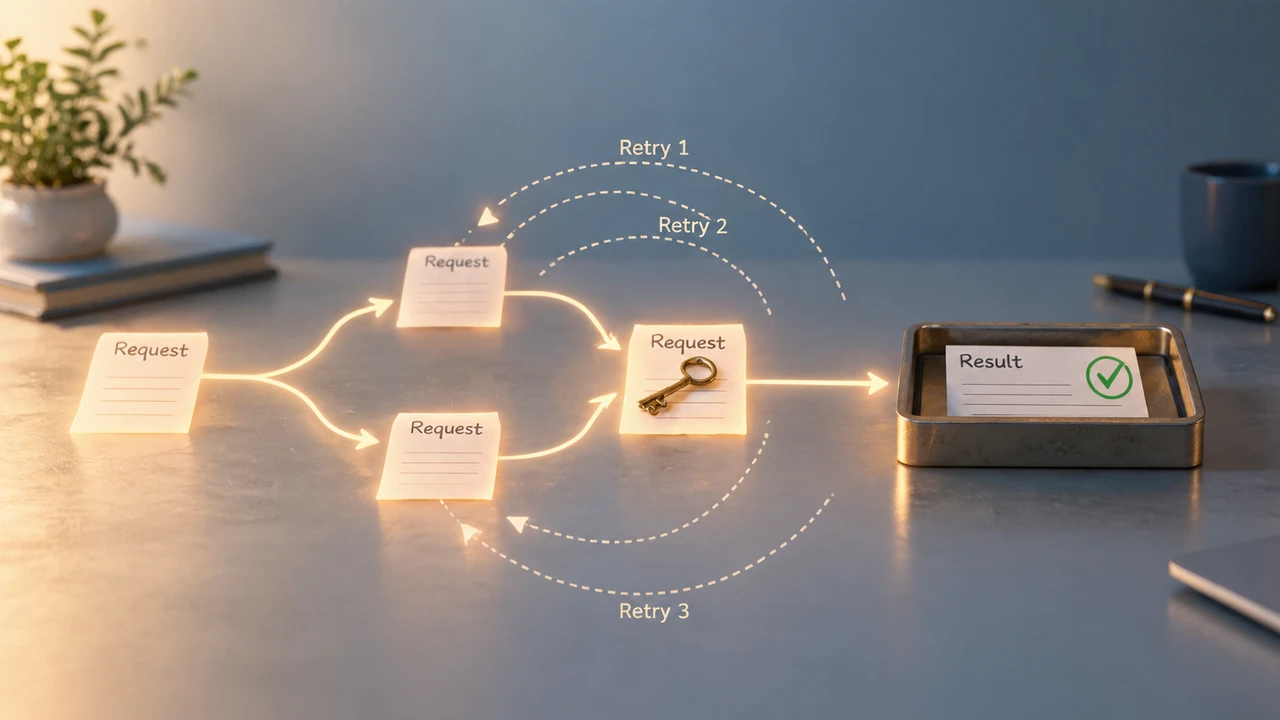
因此需要区分两件事:
- 重试:客户端再次发送请求,希望暂时性故障恢复后操作成功。
- 幂等:同一业务操作被执行或提交多次,系统对外产生的最终效果仍符合预期。
查询请求通常天然较容易做到幂等;创建、扣减、发放等写操作则需要结合业务语义设计。HTTP 方法名本身不能替代业务判断:即使使用 POST,也可以借助幂等键避免重复创建;即使请求形式相同,也不能把两次不同的用户意图误判为重复操作。
幂等键:标识一次业务意图,而不是一次网络尝试
客户端应为每一次新的业务操作生成一个高随机性、难以猜测的键,例如 UUID。关键规则是:同一操作的所有重试沿用同一个键;用户明确发起的新操作使用新键。若每次重试都生成新键,服务端就无法识别它们属于同一意图。
幂等键通常通过请求头传递,例如 Idempotency-Key。服务端至少要明确键的作用范围,避免不同用户或不同操作意外碰撞。实践中可将租户或用户标识、接口或业务操作类型与键组合为唯一约束。还应记录请求内容的摘要:同一个键再次出现时,如果关键参数与首次请求不一致,应拒绝请求,而不是把它当成原请求的重放。
服务端的处理过程可概括为:
- 校验身份、参数和幂等键。
- 原子地登记该键为“处理中”,防止并发请求同时通过检查。
- 执行业务变更,并保存结果或可恢复的结果引用。
- 将键标记为“已完成”;重复请求返回已记录结果,或返回可查询的操作状态。
幂等记录和业务写入若能处于同一数据库事务中,通常更容易避免“业务成功、记录未写入”或“记录成功、业务未执行”的不一致。若无法放进一个事务,就要设计恢复与对账流程,处理进程崩溃、锁过期和部分成功等情况。处理中请求也不能无限等待:可返回处理中状态并提供查询方式,或在明确安全的条件下允许客户端稍后重试。
键的保留时间应覆盖业务允许的重试和结果查询窗口,同时兼顾存储成本与重复操作风险。删除记录后,迟到的重试可能再次创建业务效果;对于影响长期账务或权益的数据,还应考虑以业务唯一约束、操作流水或状态校验提供更长周期的保护。幂等键不是授权凭证,也不应被用来绕过正常的身份与权限检查。
重试:只对可恢复的失败有限度尝试
重试策略先要回答两个问题:这类错误是否可能短暂恢复?这次操作是否能安全重复?
网络连接中断、服务暂时不可用或明确的限流响应,可能适合在策略允许时重试;参数错误、权限不足等明确的业务或配置错误,通常应直接返回。具体状态码的含义取决于接口契约,尤其是超时和网关错误:它们可能发生在服务端已完成操作之后。写请求只有在幂等机制可靠时,才适合对结果不确定的失败进行自动重试。
重试还需要明确边界,而不只是设一个次数:
- 最大尝试次数:避免请求无限循环。
- 总时间预算:所有重试都必须落在调用方的截止时间内,不能在用户请求已超时后继续堆积无用工作。
- 请求范围:只对明确允许的错误类型重试,并限制请求体大小、并发数等资源消耗。
- 重试层级:客户端、网关、服务和下游 SDK 若各自重试,尝试次数可能层层相乘。应明确由哪一层负责,并统计实际总尝试量。
- 降级与失败出口:超出预算后返回可识别错误、转入异步处理,或交由人工处理,不要静默无限重试。
关于可安全重试请求的条件,Google Cloud 的重试策略文档强调了请求响应与幂等性等因素;设计时应结合自己的接口契约,而不是照搬某个固定状态码列表。
指数退避与抖动:避免客户端一起“再试一次”
如果客户端一失败就立即重试,或者都固定等待相同时间,短暂故障可能触发重试风暴:负载上升导致服务恢复更慢,客户端又产生更多重试。指数退避让等待时间逐步增加;抖动则让不同客户端的重试时间错开。
一种常见的全抖动计算方式是:
第 n 次重试上限 = min(最大等待时间, 初始等待时间 × 2^n)
实际等待时间   = 在 [0, 第 n 次重试上限] 内随机取值
初始等待、最大等待和最大次数应根据服务的延迟目标、调用链剩余时间和业务时效设置,不存在适用于所有接口的通用数值。如果服务端通过 Retry-After 指定了建议等待时间,客户端应按接口约定遵守;同时仍要受自身总时间预算约束。Google 的Cloud Storage 重试策略也把响应情况与请求幂等性作为判断能否安全重试的重要依据。
退避之外,还可以用重试预算限制一段时间内的额外请求占比,并在持续故障时通过熔断或并发限制减少对下游的冲击。退避解决“何时再试”,预算和熔断解决“还要不要继续试”,三者作用不同。
异步任务与回调:把去重延伸到整条链路
同步请求返回“已受理”后,业务可能还要经过队列、消费者和外部服务。此时入口幂等不等于全链路只执行一次:消息可能重复投递,消费者可能处理完业务但未成功确认,回调也可能因接收方未及时响应而再次发送。
异步任务可使用稳定的任务 ID 或业务事件 ID,让生产者、队列消费者和结果查询共用同一业务标识。消费者应维护处理状态,并尽可能将“记录已处理”和“业务变更”放在同一事务内;无法做到时,需要可重试的恢复逻辑和定期对账。消息系统的投递语义与业务效果应分别讨论,不能仅凭“消息去重”推断业务绝不会重复。
回调接收方也应按事件 ID 去重,并验证来源和签名。若回调处理会触发下一步外部副作用,应把事件去重与该副作用的状态管理纳入同一设计。调用第三方服务时,如果对方支持幂等键,应传递稳定的业务标识;若不支持,就要考虑结果查询、人工核对或补偿机制,而不能假定本地去重足以保证外部只执行一次。
上线前的验证清单
- 同一业务操作重试时,客户端是否始终复用同一个幂等键?
- 同键但不同关键参数时,服务端是否拒绝或明确处理?
- 两个相同请求并发到达,是否可能同时通过去重检查?
- 服务端执行成功但响应丢失后,重试能否取回一致结果?
- 服务在登记幂等记录、写业务数据或返回响应的不同阶段崩溃,是否有恢复方案?
- 幂等记录何时过期?过期后的迟到请求如何防止造成不可接受的重复效果?
- 重试是否区分错误类型,并同时受次数、时间预算和并发限制约束?
- 多层调用是否会叠加重试?退避是否带随机抖动?
- 队列重复投递、重复回调和下游超时是否纳入测试?
- 监控是否能区分首次请求、重试请求、幂等命中、处理中请求与最终失败?
测试不应只覆盖“第一次成功”和“第一次失败”。还要模拟响应丢失、并发重复提交、进程中断、队列重复投递与下游长时间不可用,确认最终状态、返回结果和告警都符合预期。
【软盟资讯观察】
服务稳定性设计的一个重要方向,是把“失败后怎么办”从零散的客户端逻辑,提升为贯穿接口、数据存储、消息队列和下游依赖的契约。随着企业把更多业务能力封装为 API,幂等、超时预算、限流和可观测性不仅影响开发体验,也关系到系统能否在局部故障中保持可恢复。
机会在于,统一请求标识、错误语义和重试规范,可以减少团队间的重复摸索,让故障排查更有依据;风险在于,自动重试容易被误当作可靠性本身,掩盖接口语义含混、状态记录不完整和依赖链过长等问题。冷静看,系统无法仅靠“只执行一次”的承诺消除分布式环境中的不确定性。更务实的目标,是让重复请求可识别、操作结果可查询、异常能够收敛,并为无法自动判断的情况保留对账与人工处置通道。