


华为在2026年全联接大会上提出的Peerium计算架构,通过嵌套并行、统一内存寻址与平等互联,试图让数千乃至百万颗处理器像一台计算机运行。核心突破在于它摒弃了传统的冯·诺依曼单机架构和主从架构模式,为超大规模算力集群提供了平等协同的理论基础。这项设计被视为华为AI算力布局的重要里程碑,直接服务于需要海量处理器协同工作的训练与推理场景。
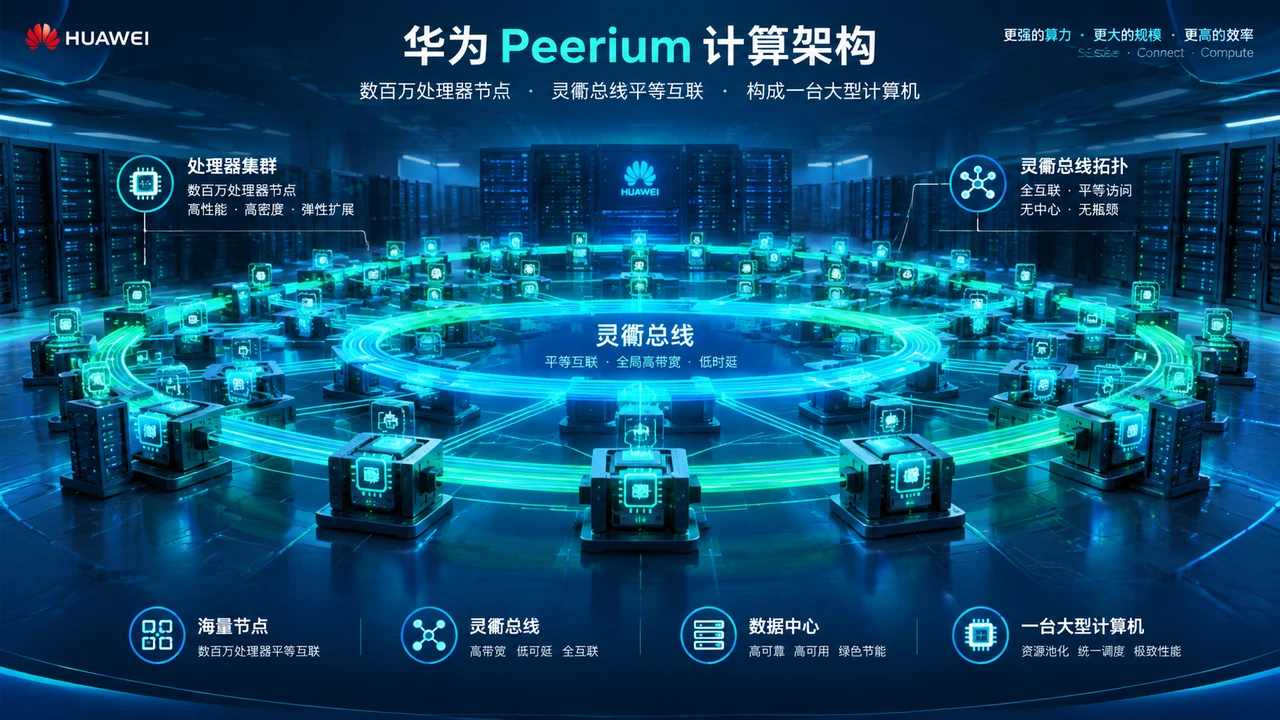
Peerium架构的核心原理
Peerium的提出直接回应了AI算力扩展的现实需求。当处理器规模从几千扩展到数万乃至百万时,传统的主从架构难以维持高效协同。徐直军在媒体圆桌交流中强调,这一架构的核心是实现“百万处理器成为一台计算机”的目标。它通过Nested BSP(嵌套并行)模式突破图灵范式,将并行计算嵌套到更高层级,同时引入统一内存寻址机制,确保所有处理器都能平等访问同一地址空间,而非依赖主控节点分派任务。
这种设计打破了冯·诺依曼单机架构的瓶颈——传统单机架构强调串行指令流和集中式控制,而Peerium则强调平等互联与分布式协同。廖恒博士在交流中指出,灵衢总线(UnifiedBus)正是这一理念的技术载体,它不是简单的互联接口,而是构建整个架构的底层协议栈。通过五层协议设计替代传统PCIe+NVLink+RDMA组合,灵衢实现了从物理层到生态层的全覆盖支持,目标是让8192卡规模的集群实现无收敛全互联。
灵衢总线:平等互联的协议支撑
灵衢总线被业界称为华为AI算力布局的关键命门。它采用统一的总线语义而非分层的私有协议,核心在于消除传统互联技术的碎片化。通过CloudMatrix384与UB-Mesh两种拓扑取舍,灵衢在协议层面提供可扩展的平等连接能力。相比NVLink或RDMA,灵衢更注重开放性和可移植性,这使其成为Peerium架构的天然配套。
在超节点层面,灵衢直接支撑了Atlas 950等产品形态。超节点不再是孤立的计算单元,而是通过灵衢构建的平等协同体。白皮书级参考架构显示,灵衢协议与超节点拓扑需分开理解:协议定义通信规则,拓扑则决定物理连接方式。<|eos|>