


云原生的真正价值,不在于叠加更多工具,而在于把混乱的技术栈重新划出一条清晰的边界:哪些复杂度交给平台统一消化,哪些能力留在业务团队手里。过去几年里,很多团队把"上云原生"等同于拆微服务、上 Kubernetes、接服务网格,结果运维人力不降反升,交付反而变慢。问题几乎都出在同一个地方——复杂度没有被消除,只是从一处转移到了另一处。如果转移的方向错了,复杂度就会落在最不该承担它的人身上,也就是写业务代码的工程师。
复杂度从哪里来,又被转移到了哪里
云原生应用的运维复杂度,主要集中在五个环节:服务拆分、容器编排、配置管理、可观测性和发布流程。单体应用时代,这五件事往往由一套工具、一个团队、一份部署脚本就能覆盖。拆成微服务之后,每一个环节都被放大。
以电商系统为例,把订单、库存、支付拆成独立服务后,容器化本身并不难——Docker 把应用和依赖打包成镜像,Kubernetes 通过 Deployment 定义副本数、用 livenessProbe 做健康检查,异常实例自动重启。但真正的负担在于,原本一次发布变成了多次协调发布,原本一份配置变成了几十份环境配置,原本一条调用栈变成了跨多个服务的分布式链路。腾讯云一篇云原生落地指南里把这种现象概括为"平台+应用的分层思想":共性技术能力(消息、缓存、数据库服务)应当下沉到平台层,上层应用只聚焦业务逻辑。
这句话的另一层含义是:微服务拆分带来的复杂度,本质上是一次复杂度再分配。如果平台层接不住,这些复杂度就会原封不动地压到业务团队头上——开发人员被迫去和 YAML 文件、集群配置、告警规则死磕。5iOPS 的一篇趋势观察说得直接:DevOps 在实践中常常退化成"运维让开发做运维",复杂的云原生技术栈给开发人员带来了沉重的认知负荷。平台工程之所以成为近年最被关注的方向,正是对这种错误转移的纠偏。
平台与业务的边界该画在哪里
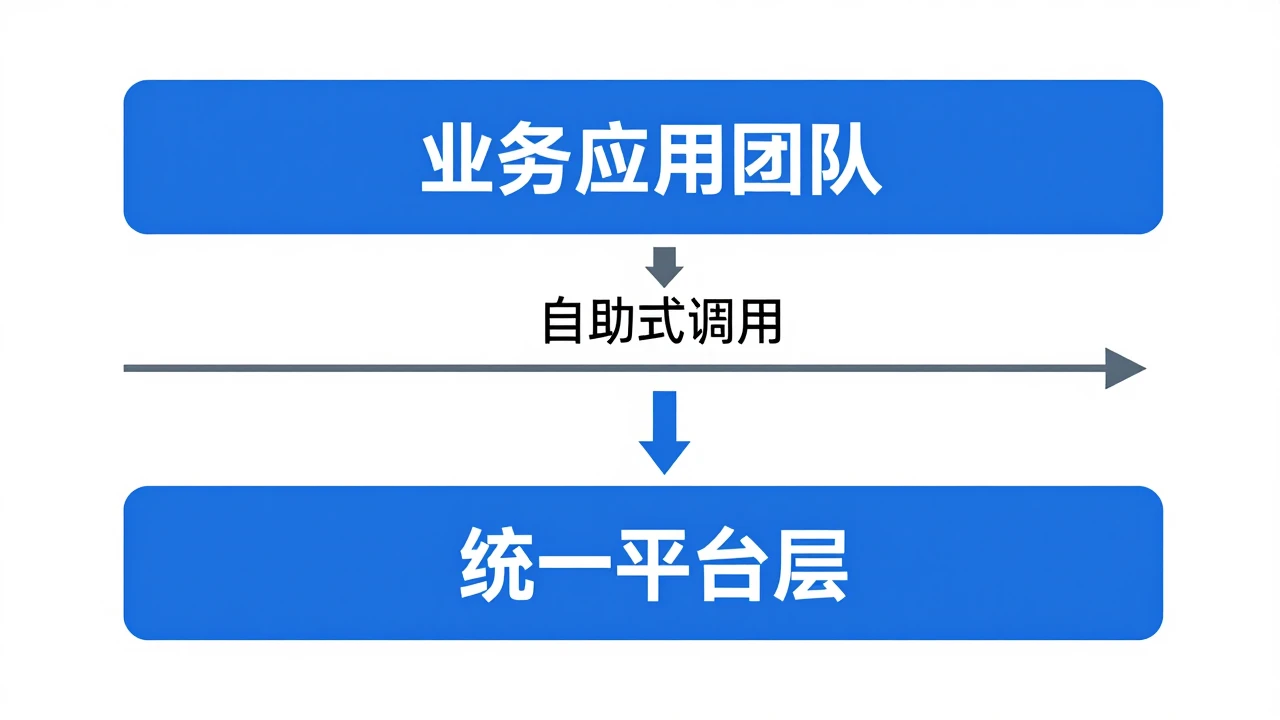
平台工程的核心思想,是为开发团队构建"内部开发者平台(IDP)",通过自助式服务、标准化流水线和"黄金路径",把底层基础设施的复杂性抽象掉。开发者只需要关心业务代码的部署与运行,而不必亲自管理集群细节。这是一条判断边界的实用原则:凡是跨团队重复出现、与业务逻辑无关、且需要专业知识才能做对的能力,都应该由平台统一提供;凡是与具体业务规则强绑定、不同团队诉求差异大的能力,应该留在业务团队。
下面这张表给出一个可操作的划分参考,具体权重应结合团队规模和系统复杂度调整。
| 能力环节 | 建议归属平台 | 建议保留业务 |
|---|---|---|
| 容器编排与调度 | 集群运维、资源配额、弹性伸缩策略模板 | 单个服务的资源申请值、扩缩容触发阈值 |
| 配置管理 | 配置中心、密钥管理、环境分级规范 | 业务参数、功能开关、特定依赖配置 |
| 可观测性 | 日志采集、指标存储、链路追踪基础设施 | 业务关键指标定义、告警规则、SLO 目标 |
| 发布流程 | GitOps 流水线、发布策略模板、权限审计 | 发布时机、灰度范围、回滚判断 |
| 服务治理 | 服务网格基础设施、通用限流熔断能力 | 具体路由规则、重试与超时的业务取舍 |
需要强调的是,平台提供"能力"不等于平台替业务"做决定"。比如弹性伸缩,平台应该提供好用的 HPA 模板——当 CPU 使用率超过 70% 自动扩容、低于某阈值缩容——但具体设成多少、最小副本几个,仍然由最了解流量特征的业务团队决定。平台负责把工具做对、做稳、做到自助,业务负责在这些工具上做符合自身场景的选择。
可观测性为什么必须由平台兜底
五个环节里,可观测性最容易被低估,也最适合用来说明"为什么某些能力必须下沉"。微服务和容器化普及后,系统变得高度动态且碎片化,传统监控手段很难定位故障。可观测性早期被概括为日志、指标、链路"三大支柱",但在分布式环境里,光有三支柱还不够,关键是要能把它们关联起来。
这里有一个值得关注的技术变化:eBPF。它允许在不修改内核源码、不重启应用的情况下,在 Linux 内核中安全运行沙箱程序,从而实现"无侵入式"的全栈可观测性——网络丢包分析、系统调用追踪、应用延迟拆解都能以较低的性能开销完成。对边界划分而言,eBPF 的意义在于:这类采集能力一旦做好,就能同时服务所有业务,让每个团队重复接入埋点既浪费又容易做错。所以采集与存储这层基础设施,是典型的"应该由平台兜底"的能力。而哪些指标算关键、告警阈值怎么设、SLO 定多高,这些和业务紧密相关的判断,则应该留给最懂业务的人。
与此同时,大模型正在改变运维的交互方式。基于自然语言的 ChatOps 开始落地,运维人员用自然语言描述需求即可生成 Ansible Playbook 或 Terraform 代码;大模型在根因分析中也展现出跨越指标、日志和链路的能力。这类能力更应作为平台的增强工具存在,用来降低专家的心智负担,而不是又给业务团队增加一套需要学习的新系统。
分阶段改造:先建标准,再提治理
把边界理清之后,改造不宜一步到位。参考业界常见的渐进式演进路径,可以分成三个阶段:
- 第一阶段,基础能力建设。统一技术标准、引入 DevOps 工具链和容器云平台,先把发布流程和基础监控做成自助式。这个阶段的目标是止损——不让复杂度继续错误地压向业务团队。
- 第二阶段,能力提升。深化微服务治理、API 网关、配置中心和链路追踪,把服务网格等基础设施收归平台。这个阶段开始真正降低单位服务的运维成本。
- 第三阶段,闭环优化。构建"监控→分析→决策→执行"的自动化数据闭环,引入混沌工程验证系统韧性,让平台具备主动发现和预警能力。
每个阶段都应该有可衡量的产出,而不是以"上了多少工具"论成败。改造效果应当用三类指标衡量:稳定性(如故障恢复时间 MTTR、SLO 达成率)、交付效率(如从提交到上线的周期、发布频率)、运维人力(如单位服务所需的运维投入、开发者自助完成任务的比例)。如果一轮改造之后这三类指标没有改善,就说明复杂度要么没被消除,要么又被转移错了方向。
什么情况下不该拆微服务
最后要泼一盆冷水:微服务不是所有系统的默认答案。它本质上是用架构、组织和平台能力的共同演进,去换取大规模协作下的交付灵活性。如果团队规模不大、业务边界尚不清晰、也没有能力建设平台层,那么强行拆分只会把本可以一次搞定的事情,变成几十个服务之间无休止的协调。
判断是否适合走云原生微服务路线,可以先回答三个问题:团队是否大到需要并行独立交付?业务边界是否清晰到可以稳定拆分?是否有能力和意愿去建设并长期维护平台层?三个问题中如果有两个是否定的,更务实的做法往往是先把单体做好模块化,等组织和业务都成熟了再谈拆分。云原生的复杂度管理,归根结底是组织能力的问题,技术工具只是把这种能力落地的手段。
【软盟资讯观察】
从趋势判断看,平台工程的兴起标志着云原生进入"收敛期":行业不再比拼谁用的组件多,而是比拼谁能把复杂度抽象得更干净。内部开发者平台、GitOps、eBPF 可观测性、以及大模型驱动的 ChatOps,正在共同把"黄金路径"做成标配,这对缺乏专职基础设施团队的中小企业尤其是利好。
从机会与风险看,边界划分做对了,交付效率和运维人力会同步改善;做错了,平台层反而会变成新的瓶颈和成本黑洞。企业在引入大模型运维、服务网格这类能力时,应警惕把厂商宣传语当成结论,务必用稳定性、交付效率、运维人力三类指标做前后对比,再决定是否扩大投入。
冷思考一句:真正决定云原生成败的,从来不是技术栈的新旧,而是组织是否想清楚了"谁该为哪部分复杂度负责"。工具可以买,边界只能自己画。