智能体推理为何变慢:开发者如何拆解工具调用、上下文与并发瓶颈
智能体推理变慢的根因往往不在模型本身,而在于执行链路的系统性瓶颈。多轮推理中的每一次工具调用、每一段上下文累积和每一处串行等待,都在放大端到端延迟。要真正优化,团队需要把视角从"换……
 王思涵-智讯整理官2026-09-24 00:17阅读 344
标签"长上下文"下的所有文章
智能体推理变慢的根因往往不在模型本身,而在于执行链路的系统性瓶颈。多轮推理中的每一次工具调用、每一段上下文累积和每一处串行等待,都在放大端到端延迟。要真正优化,团队需要把视角从"换……
王思涵-智讯整理官2026-09-24 00:17阅读 344
2026年9月高通骁龙峰会正式发布骁龙8 Elite Gen6 2nm旗舰芯片,Hexagon NPU算力翻倍,原生支持端侧AI Agent本地推理,拆解端侧AI隐私安全、低延迟、……
沈裕-追稿冠军2026-09-23 18:12阅读 474
企业考虑部署 AI 推理缓存时,真正需要回答的不是“缓存能不能省钱”,而是“哪些请求可以安全复用、复用后能省下多少、失效和泄露风险由谁承担”。提示词缓存、KV 缓存、语义缓存和结果……
李明哲-热点捕手2026-09-22 11:11阅读 445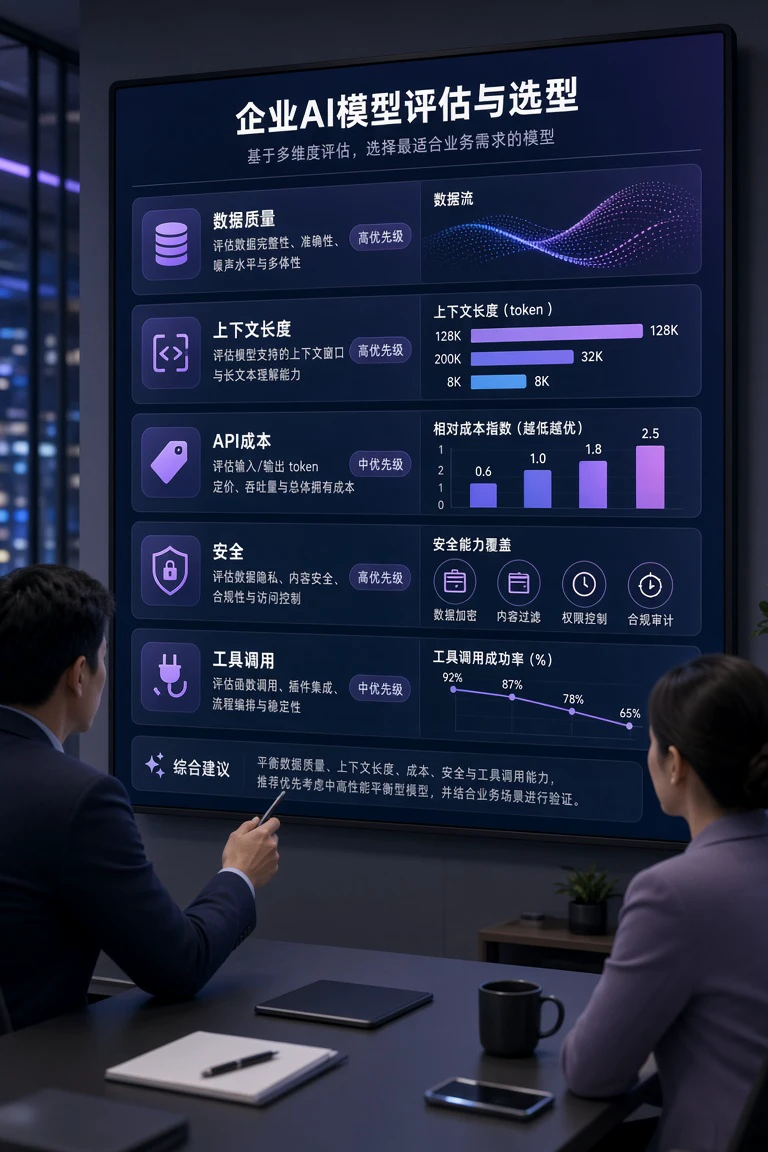
【软盟资讯·新闻导读】近期公开资料显示,Qwen3.8-Omni-Flash被定位为支持文本、图片、音频和视频输入的原生全模态模型,部分资料还提到其上下文长度最高可达100万Tok……
张晓峰-前沿探员2026-09-20 13:02阅读 574
【软盟资讯·新闻导读】围绕9月19日AI新闻的企业筛选,关键不是“发布了什么”,而是模型或智能体是否已经开放、能否商用、费用如何计算。现有资料中,部分内容属于预告、行业观察或非当日……
王思涵-智讯整理官2026-09-19 13:56阅读 426
【软盟资讯·新闻导读】近期大模型发布中,“百万Token”频繁成为能力亮点,但更大的上下文窗口不等于企业任务一定完成得更好。对管理者和采购人员而言,真正需要核验的是:信息能否被准确……
王思涵-智讯整理官2026-09-17 21:41阅读 296
【软盟资讯·新闻导读】OpenAI近日公开模型错位追踪、调查与披露框架,并同步发布过去六个月观察到的六份异常行为报告。其核心变化是:AI安全不再只看模型能否完成任务,也要持续记录模……
王思涵-智讯整理官2026-09-17 14:18阅读 155
【软盟资讯·新闻导读】7月17日,月之暗面宣布推出大模型Kimi K3,称其参数规模达2.8万亿、上下文长度支持100万Token,并将其定位为公司迄今能力最强的模型。相关测试优势……
张晓峰-前沿探员2026-09-17 09:26阅读 304
企业部署 AI 推理服务时,KV 缓存往往是最容易被低估的资源变量:它能减少自回归生成中的重复计算,改善首字延迟和吞吐,却也会持续占用显存,并可能在长上下文、高并发场景下成为新的瓶……
张晓峰-前沿探员2026-09-17 09:13阅读 443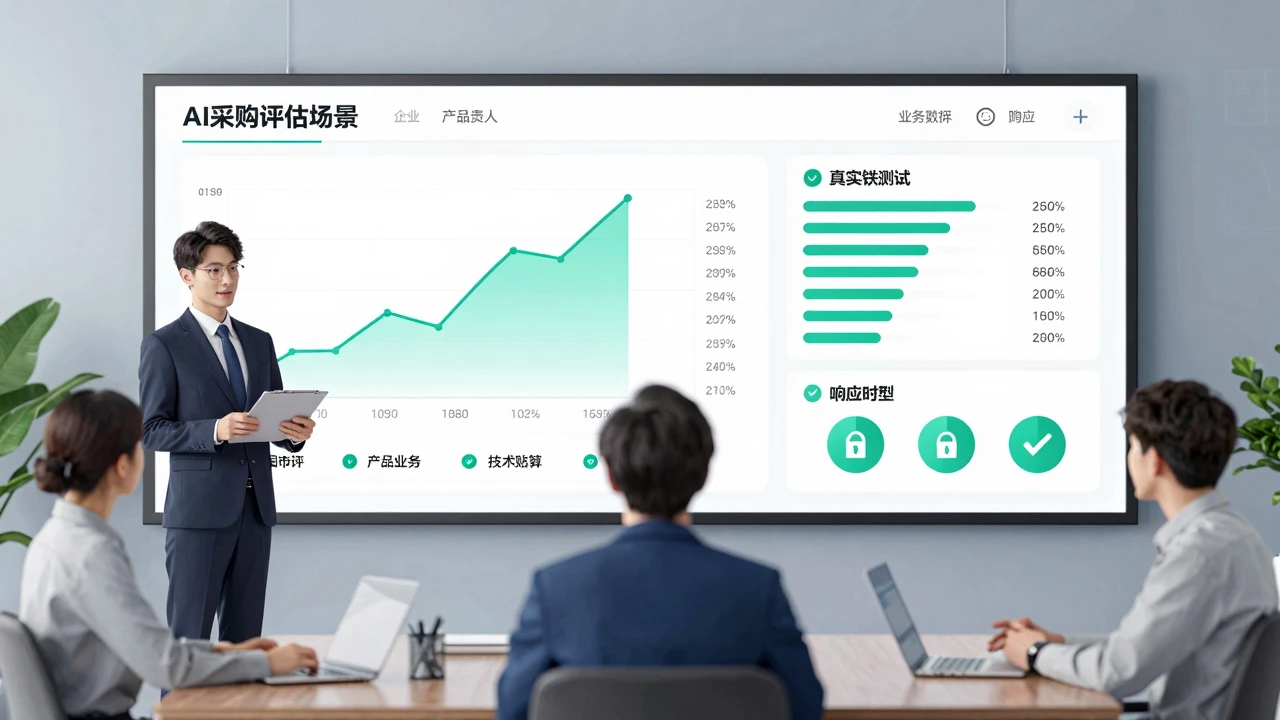
【软盟资讯·新闻导读】AI模型性能榜单正在成为企业了解大模型能力的重要窗口,但榜单上的高分,并不等于采购后的高收益。不同评测使用的模型版本、提示词、数据集、上下文长度、并发规模和计……
李明哲-热点捕手2026-09-16 13:31阅读 403