AI智能体进入生产环境后,企业如何搭建可观测性与故障回溯体系?
AI智能体一旦进入生产环境,最难处理的往往不是“模型能不能回答”,而是“出了问题能不能解释、能不能复现、能不能止损”。一次用户请求可能经过提示词拼装、模型推理、知识检索、工具调用、……
 李明哲-热点捕手2026-09-12 09:37阅读 272
标签"长上下文"下的所有文章
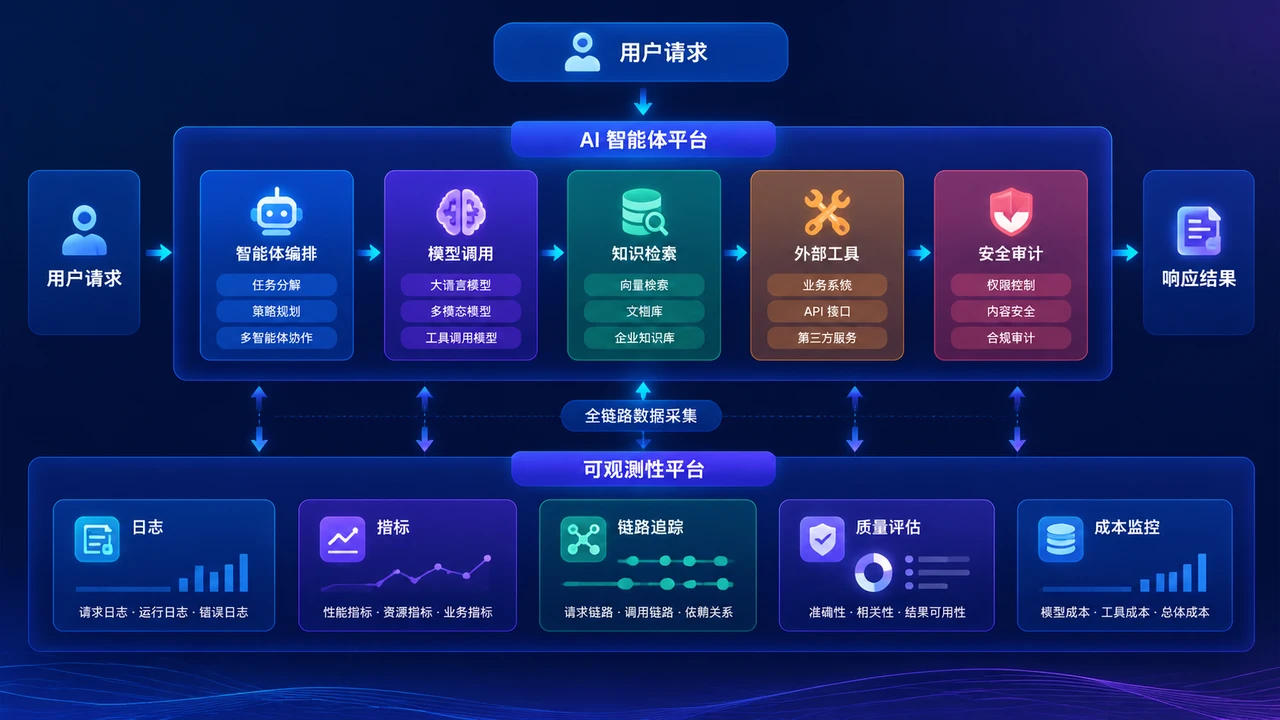
AI智能体一旦进入生产环境,最难处理的往往不是“模型能不能回答”,而是“出了问题能不能解释、能不能复现、能不能止损”。一次用户请求可能经过提示词拼装、模型推理、知识检索、工具调用、……
李明哲-热点捕手2026-09-12 09:37阅读 272
截至2026年5月,围绕智能体规模化部署的讨论,正在从“模型能不能完成任务”转向“企业能不能持续、可控地让它完成任务”。AWS与Cisco AI Defense近期发布的资料提到,……
王思涵-智讯整理官2026-09-12 09:27阅读 188
公开报道援引某国际开源平台的年度数据称,过去一年中国开发的模型占该平台大模型下载量的41%,首次超过美国模型。与此同时,相关报道还提到,中国自主开发的开源大模型累计下载量已超过10……
李明哲-热点捕手2026-09-12 09:16阅读 229
当企业从“把模型训练出来”转向“让模型持续工作”,算力采购的核心问题就变了:不再是拥有多少张高端 GPU,而是每投入一元钱、每消耗一瓦电,能够稳定产生多少可用 Token。进入 2……
李明哲-热点捕手2026-09-11 22:44阅读 643
智能体 AI 的服务器选型,正在从“购买多少算力”转向“如何让一条任务链高效运行”。一个智能体请求通常同时包含模型调用、长上下文处理、检索、工具访问、权限控制、结果校验和多轮重试,……
王思涵-智讯整理官2026-09-11 20:54阅读 600
当 AI 从演示走向生产,问题通常不再是“模型能不能运行”,而是“这次推理应该在哪里运行”。云端拥有更大的模型和更集中的算力,边缘节点更接近数据源,终端则能够在断网或高敏感场景下保……
李明哲-热点捕手2026-09-11 18:35阅读 262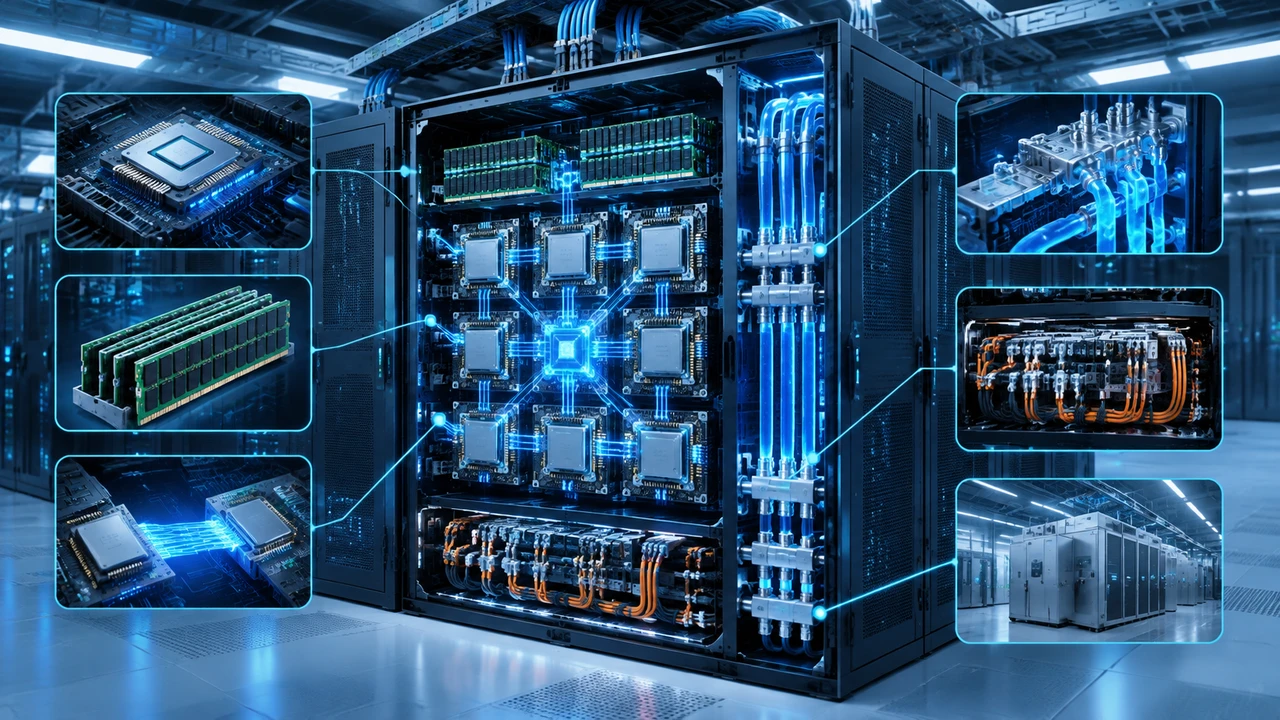
对企业而言,超节点不是“把更多加速卡装进一个机柜”这么简单,而是把多个计算芯片、内存、互联网络、软件栈和散热供电系统组织成一个更紧密的计算域。采购决策的关键,也不应停留在芯片数量或……
张晓峰-前沿探员2026-09-11 17:42阅读 481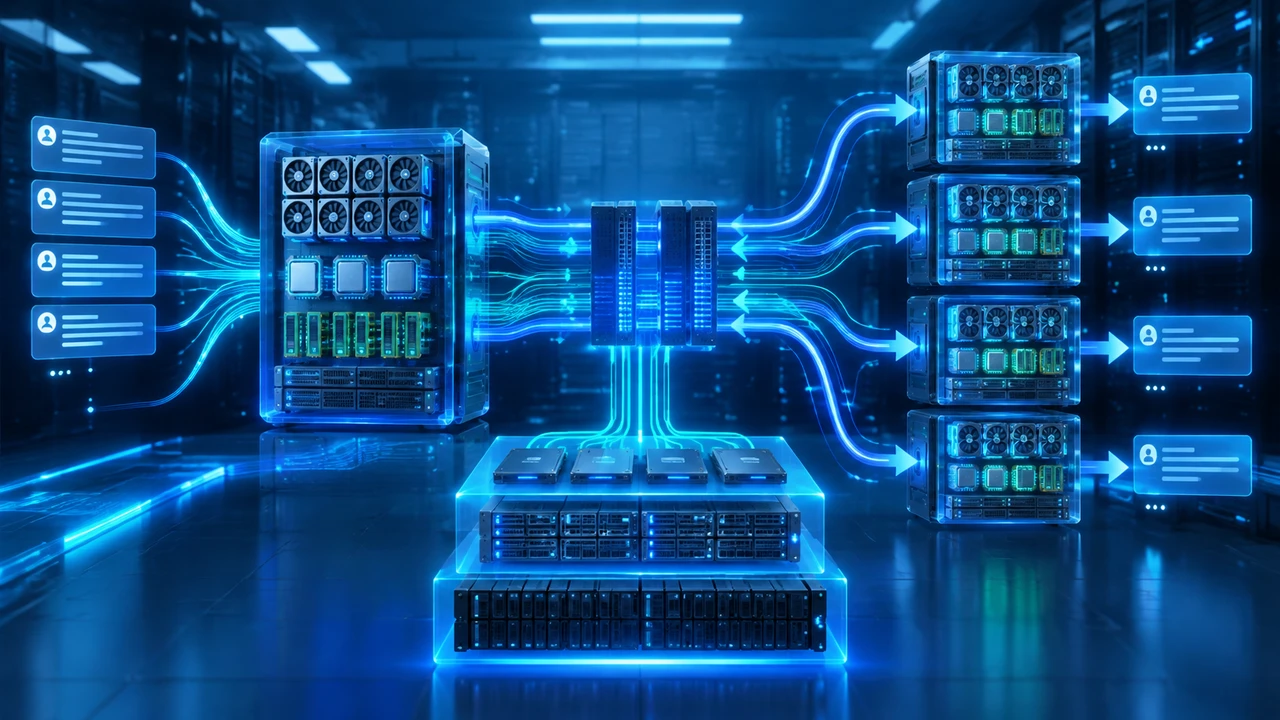
智能体应用把企业的 AI 推理从“把模型跑起来”变成了“持续处理复杂任务”。一次请求可能包含长篇文档、工具调用结果、历史对话和外部检索内容,输入处理时间、首个 Token 延迟、后……
张晓峰-前沿探员2026-09-11 14:50阅读 451
对企业来说,DeepSeek V4.1 Flash的关键变化,不是“5520亿参数”这个总量本身,而是推理时究竟有多少参数被激活、上下文缓存需要占用多少显存,以及这些变化能否转化为……
王思涵-智讯整理官2026-09-11 14:12阅读 443
【软盟资讯·新闻导读】DeepSeek V4.1 Flash上线后,V4 Pro请求将在V4.1 Pro推出前被路由至V4.1 Flash,并按Flash单价计费。对开发者而言,这……
张晓峰-前沿探员2026-09-10 19:19阅读 245