【软盟资讯·技术导读】AI服务器功耗持续上升,传统风冷在机柜功率密度、噪声、空间和能耗方面逐渐接近工程边界。液冷并不是单一产品,而是一组涵盖冷板式、单相浸没式和两相浸没式的散热架构。企业真正需要判断的,不是“要不要上液冷”,而是芯片功耗、机柜密度、机房条件、改造周期和运维能力是否已经匹配某种液冷方案。
为什么AI算力扩容正在改变散热架构
传统风冷依靠冷空气经过服务器内部,将芯片、内存、供电模块和其他部件产生的热量带走。当单机柜功率仍处于较低水平时,风冷系统具有设备成熟、兼容性好、改造简单等优势。
但AI算力集群通常包含大量高功耗GPU、加速卡和高速互联设备。随着单台服务器功耗增加,机柜的热流密度也随之上升,风冷会面临几类问题:
- 需要更大的送风量和更低的送风温度;
- 机房空调、风机和末端气流组织的能耗增加;
- 高密度机柜可能出现局部热点;
- 机柜功率受限,算力扩容被机房供配电和散热能力“卡住”;
- 服务器风扇转速上升,噪声、灰尘和部件老化风险随之增加。
因此,液冷技术的价值不只是“把温度降下来”,更在于把热量从服务器内部更高效地转移到设施侧,释放机柜功率密度和数据中心空间的约束。
三类散热架构的工作原理
冷板式液冷:保留服务器形态,重点冷却高热源部件
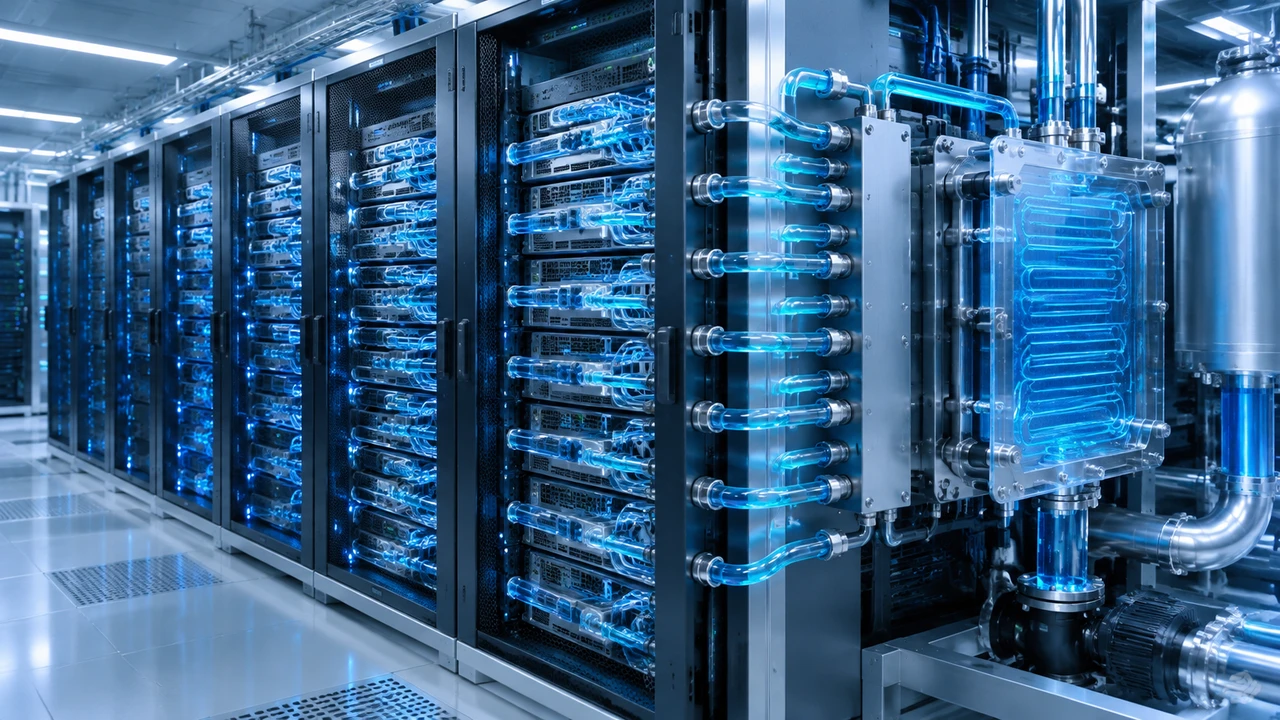
冷板式液冷在芯片或加速卡表面安装带有流道的冷板,冷却液在冷板内部循环,吸收处理器产生的热量,再通过冷却分配单元、换热器和室外散热设备排出。
它通常只覆盖CPU、GPU、加速卡等主要热源,内存、硬盘、电源和主板其他元件仍可能依赖风冷。因此,冷板式液冷往往是“液冷为主、风冷为辅”的混合架构。
其主要优势是:
- 与现有服务器形态和机柜体系相对接近;
- 适合从部分机柜或部分节点开始改造;
- 对服务器拆装、运维流程和备件体系的冲击相对可控;
- 便于与现有数据中心的风冷系统并行运行。
需要注意的是,冷板式液冷并不意味着服务器完全没有风扇,也不代表所有部件都被液体冷却。企业在选型时,应确认冷却覆盖范围、允许的进液温度、流量要求、漏液检测和快速维护机制。
单相浸没式液冷:让整台设备浸入绝缘液体
单相浸没式液冷将服务器主板及相关组件浸入不导电的液体中。液体吸收热量后升温,再通过循环泵输送至换热器,由设施侧水路或其他散热系统完成降温。
由于服务器大部分发热部件都处于液体环境中,单相浸没式液冷可以减少对局部风道的依赖,并有利于降低风扇功耗和机房气流组织压力。
但它对运维方式的改变更明显:
- 服务器需要适配绝缘液环境;
- 设备上下架、检修和备件更换流程不同于普通机架服务器;
- 液体管理、过滤、污染控制和材料兼容性需要纳入运维体系;
- 浸没槽、循环系统和检修空间会改变机房布局。
因此,单相浸没式液冷更适合新建高密度算力区,或设备型号相对统一、运营周期较长的专用集群。
两相浸没式液冷:利用相变带走热量
两相浸没式液冷利用工质沸腾吸热,蒸汽上升后在冷凝结构中重新液化,再回流到液槽。它的核心优势是借助相变过程实现较高效的热传递,并减少部分机械循环需求。
不过,两相方案对工质、密封、压力控制、材料兼容性和环保合规提出了更高要求。其长期运维经验、供应链保障和事故处置流程,也需要企业在采购前充分验证。
对于大多数企业而言,两相浸没式液冷不应仅凭理论散热效率做决定,而要同时评估工质供应、设备兼容、人员培训和未来替换成本。
冷板式与浸没式如何比较
| 评估维度 | 冷板式液冷 | 单相浸没式液冷 | 两相浸没式液冷 |
|---|---|---|---|
| 适合场景 | 现有机房改造、高密度GPU机柜、混合部署 | 新建高密度算力区、设备型号较统一 | 对高热流密度和系统集成能力要求较高的专用场景 |
| 对服务器改造 | 通常较少,但需更换或适配冷板、管路和节点 | 需要确认整机、材料和部件是否适配液体 | 对设备、密封和工质适配要求更高 |
| 机房兼容性 | 较好,可与风冷并行 | 需要浸没槽、液体管理和专用维护空间 | 需要更复杂的相变、冷凝和安全设计 |
| 运维门槛 | 中等,接近传统服务器运维模式 | 较高,检修、清洁和液体管理流程变化明显 | 高,对工程能力和供应链依赖更强 |
| 扩容方式 | 可按机柜或机架逐步扩展 | 更适合按槽体和算力单元扩展 | 通常需要更完整的系统规划 |
| 主要风险 | 漏液、接头可靠性、部分部件仍需风冷 | 液体兼容性、检修效率、设备标准化 | 工质、密封、环保合规和长期维护 |
从落地难度看,冷板式液冷通常更适合作为风冷向液冷迁移的第一步;从整体浸没和机房气流优化看,浸没式液冷的潜力更大,但其系统边界也更宽,不能只按服务器采购项目评估。
不要只看芯片TDP,应看机柜功率密度
企业在选择液冷方案时,最容易犯的错误,是直接用单颗芯片的TDP做判断。TDP只能反映芯片设计热设计功耗,不能完整代表服务器功耗、机柜功耗和机房侧散热负载。
更有效的判断顺序是:
- 统计服务器整机功耗,而不是只统计CPU或GPU功耗;
- 计算目标机柜的持续功率、峰值功率和未来扩容功率;
- 评估机房供电、配电、空调和冷源是否有余量;
- 区分训练集群、推理集群和普通业务服务器的负载特征;
- 判断是否需要保留不同型号设备的混合部署能力。
在缺少详细实测数据时,可以把机柜功率密度作为初筛指标,而不是绝对标准:
- 低密度机柜:优先评估风冷优化,包括冷热通道、封闭通道和气流组织;
- 中等密度机柜:评估风冷增强与冷板式液冷的混合方案;
- 高密度AI机柜:优先验证冷板式液冷,并同步核算CDU、管路和冷源能力;
- 超高密度或专用算力区:再比较单相、两相浸没式液冷的全生命周期成本。
这些区间只能作为项目初筛,不能替代热设计和现场测试。不同服务器型号、芯片封装、机柜高度、工作负载和进液温度,都会改变最终结果。
PUE会改善多少,取决于“液冷系统增加了什么”
PUE的计算方式是:
PUE = 数据中心总能耗 ÷ IT设备能耗
液冷能够减少部分机房送风、制冷和服务器风扇能耗,但同时也可能增加冷却泵、CDU、换热器、控制系统和液体循环设备的能耗。因此,液冷不会自动带来PUE下降。
企业应拆分改造前后的能耗:
- IT设备本体能耗;
- 服务器风扇能耗;
- 空调和冷冻水系统能耗;
- CDU与循环泵能耗;
- 室外散热设备能耗;
- 监控、控制和备用系统能耗。
例如,若IT负载为1兆瓦,冷却及配套系统消耗为0.2兆瓦,则对应PUE为1.2。改造后,即使空调侧能耗下降,如果新增液冷循环设备和冷源系统消耗0.1兆瓦,企业仍需以整体实测结果判断是否真正改善。
相比单纯追求一个PUE数字,更应关注三个问题:在相同IT负载下总能耗是否下降,单位算力能耗是否下降,以及是否因为液冷释放了更高的机柜功率密度。对于AI数据中心,后两个指标往往与业务扩容更直接相关。
成本评估要覆盖全生命周期
液冷初期投资通常不只包括液冷服务器或冷板,还包括一整套基础设施改造。企业可以按以下五类成本建立模型。
设备与部署成本
包括冷板、管路、CDU、浸没槽、换热器、循环泵、阀件、传感器和控制系统等。浸没式方案还要考虑液体采购、储存、补充和处理成本。
机房改造成本
包括承重、地面、机柜、供配电、冷源、管路、排水、漏液检测、消防和维护空间。老旧机房可能需要先解决供电容量和冷源能力,液冷本身反而不是最大成本项。
服务器适配成本
包括主板、散热组件、快拆接头、机箱结构、固件兼容、质保条款和备件替换。若企业使用多品牌、多代际服务器,兼容性成本可能显著上升。
运维与培训成本
包括液体检测、管路巡检、过滤更换、设备清洁、检修工具、应急预案和人员培训。浸没式方案还需要重新设计服务器上下架、故障定位和维修外送流程。
停机与迁移成本
改造过程中可能涉及机柜迁移、业务切换、测试窗口和备用算力采购。对于在线业务或训练任务密集型集群,停机风险应单独计入投资回报模型。
建议企业采用“每千瓦IT负载全生命周期成本”进行比较,而不是只比较一台服务器或一个机柜的采购价。
从风冷过渡到液冷的四步路径
第一步:建立热与电的基线
至少连续采集服务器功耗、机柜功率、进回风温度、热点温度、风扇转速、空调负载和业务利用率。没有基线,就无法判断液冷改造到底节省了多少能耗,也无法发现性能瓶颈来自芯片、网络还是散热。
第二步:选择可控范围做试点
优先选择业务边界清晰、服务器型号统一、负载稳定的GPU集群做试点。试点不宜一开始就覆盖整个机房,应保留风冷区作为对照组。
冷板式液冷适合验证单柜或少量机柜;浸没式液冷则应以完整槽体、循环系统和维护流程作为试点单元,不能只测试一台浸没服务器。
第三步:验证运行、维护和故障场景
测试内容不应只包含满载温度,还应包括:
- 负载快速变化时的温控响应;
- 循环泵或CDU故障时的保护策略;
- 漏液、流量不足和温度异常告警;
- 服务器上下架和部件更换时间;
- 业务迁移、节点重启和故障隔离;
- 断电恢复与应急散热能力。
只有在这些场景下仍能保持可运维,方案才具备规模化条件。
第四步:按算力集群分批扩容
新建AI算力区可以优先规划液冷基础设施,保留部分风冷机柜用于通用服务器和低密度业务。存量机房则更适合采用“风冷优化—混合部署—局部液冷—专用液冷区”的渐进路径,避免一次性改造带来的停机和兼容风险。
迁移过程中最容易被忽视的风险
漏液风险。 液冷系统必须设置流量、压力、温度和漏液检测,并明确告警后的自动隔离策略。仅依靠人工巡检不足以覆盖高密度机柜的运行风险。
供应商锁定。 冷板接口、CDU协议、液体规格和服务器适配可能形成较强绑定。采购时应确认备件周期、接口标准、替代供应商和退出方案。
兼容性风险。 不同代际芯片、加速卡、主板和机箱对液冷的支持程度不同。不能把一套液冷系统默认适用于所有服务器。
运维能力不足。 液冷改变的不只是设备,而是巡检、维修、备件、消防和应急流程。企业需要把设施运维团队与IT运维团队纳入同一套责任边界。
节能预期过高。 如果服务器利用率低、冷源效率差或液冷泵组设计不合理,液冷可能没有带来预期的PUE改善。算力负载、冷源条件和系统控制策略必须一起评估。
选型结论:先看密度,再看改造边界
对于仍以通用服务器为主、机柜功率密度不高的企业,优先优化冷热通道、封闭通道和空调控制,未必需要立即部署液冷。
对于高功耗GPU服务器和高密度AI算力集群,冷板式液冷通常是更容易落地的过渡方案,尤其适合存量机房改造和风冷、液冷并行运行。
对于新建、设备高度标准化、追求更高热密度和更少机房气流依赖的算力中心,浸没式液冷值得进行专项论证。但企业必须同时具备较强的设施运维、设备适配和供应链管理能力。
【软盟观察】
液冷从“选配”走向“标配”,本质上不是散热器件的替换,而是AI算力基础设施从“服务器中心”转向“芯片、机柜、冷源和运维一体化”的架构升级。企业不应被单一PUE数字或某种液冷形式的理论性能牵着走,而应把芯片功耗、机柜密度、冷源余量、改造停机、运维能力和供应商退出机制放在同一张决策表中。
当前更稳妥的路径,是以真实负载建立风冷基线,再通过小规模冷板式液冷试点验证温度、能耗和维护效率;只有当业务密度、机房条件和人员能力同时成熟时,再考虑浸没式液冷等更深度的架构变化。对管理者而言,液冷的投资回报不只来自节能,也来自释放机柜容量、延长数据中心扩容周期和降低高密度算力部署的物理约束。
相关话题
关于文章版权的声明:
https://news.softunis.com/79645.html 文章来自软盟资讯
若非本站原创的文章,特别作如下声明:
本文刊载所有内容仅供提供信息交流和业务探讨而非提供法律建议目的使用,不代表任何监管机构的立场和观点。不承担任何由于内容的合法性及真实性所引起的争议和法律责任。
凡注明为其他媒体来源的信息,均为转载,版权归版权所有人所有。
如有未注明作者及出处的文章和资料等素材,请版权所有者联系我们,我们将及时补上或者删除,共同建设自媒体信息平台,感谢你的支持!