算力基础设施从“买设备”走向“做网络”:企业如何评估调度、网络与供电协同?
企业采购 AI 算力时,真正需要验收的并不只是 GPU 数量或单卡峰值性能。训练任务能否稳定获得资源、数据能否以可接受的时延到达计算节点、供电和散热能否支撑持续负载,以及多地域资源……
 李明哲-热点捕手2026-09-11 22:37阅读 313
聚焦全球前沿技术趋势与产业应用,覆盖软件开发、云计算、区块链、元宇宙/数字孪生、网络安全五大方向。

企业采购 AI 算力时,真正需要验收的并不只是 GPU 数量或单卡峰值性能。训练任务能否稳定获得资源、数据能否以可接受的时延到达计算节点、供电和散热能否支撑持续负载,以及多地域资源……
李明哲-热点捕手2026-09-11 22:37阅读 313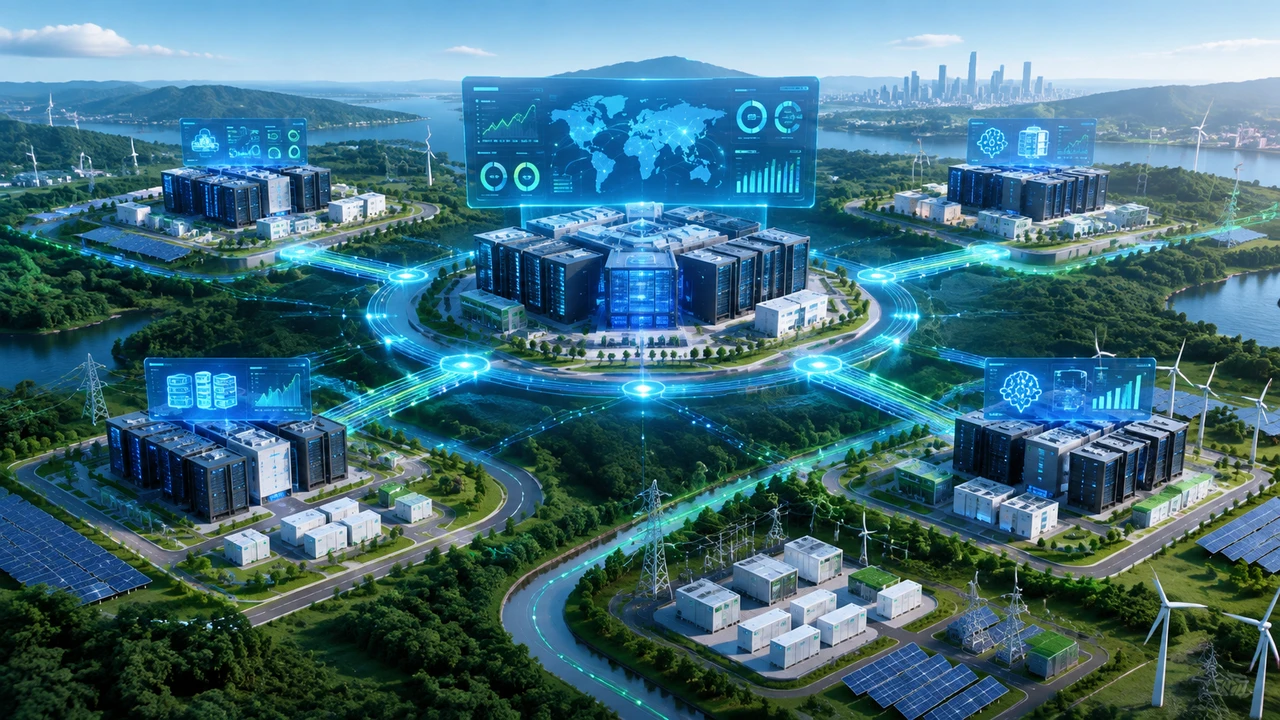
算力网建设进入协同阶段后,企业采购的对象不再只是某一型号的 GPU、某个云资源包或一座数据中心,而是一套能够持续感知资源状态、匹配任务需求、跨节点调度并稳定交付算力的系统。根据 2……
王思涵-智讯整理官2026-09-11 22:24阅读 482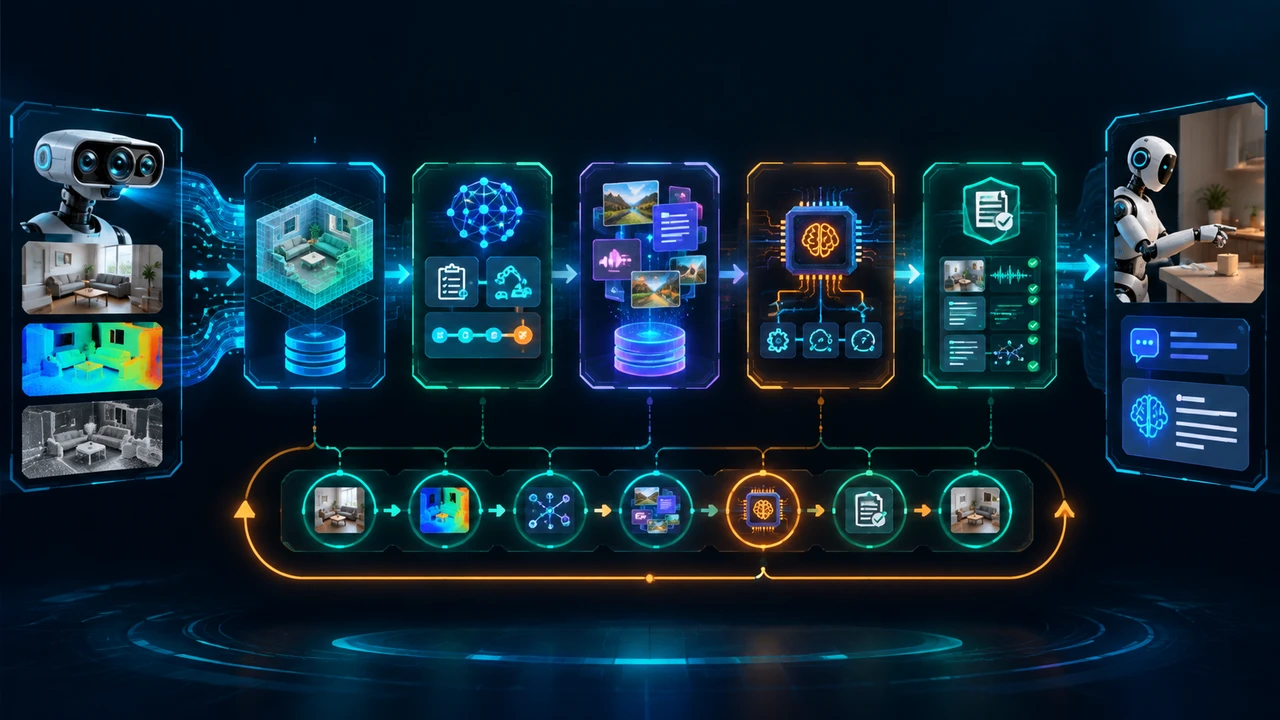
当机器人、智能体或问答系统出错时,企业真正需要的往往不是一个更大的端到端模型,而是能够回答“它在何时、依据什么、经过哪一步作出决定”的中间接口。2026年9月7日至10日公开的几项……
王思涵-智讯整理官2026-09-11 21:50阅读 317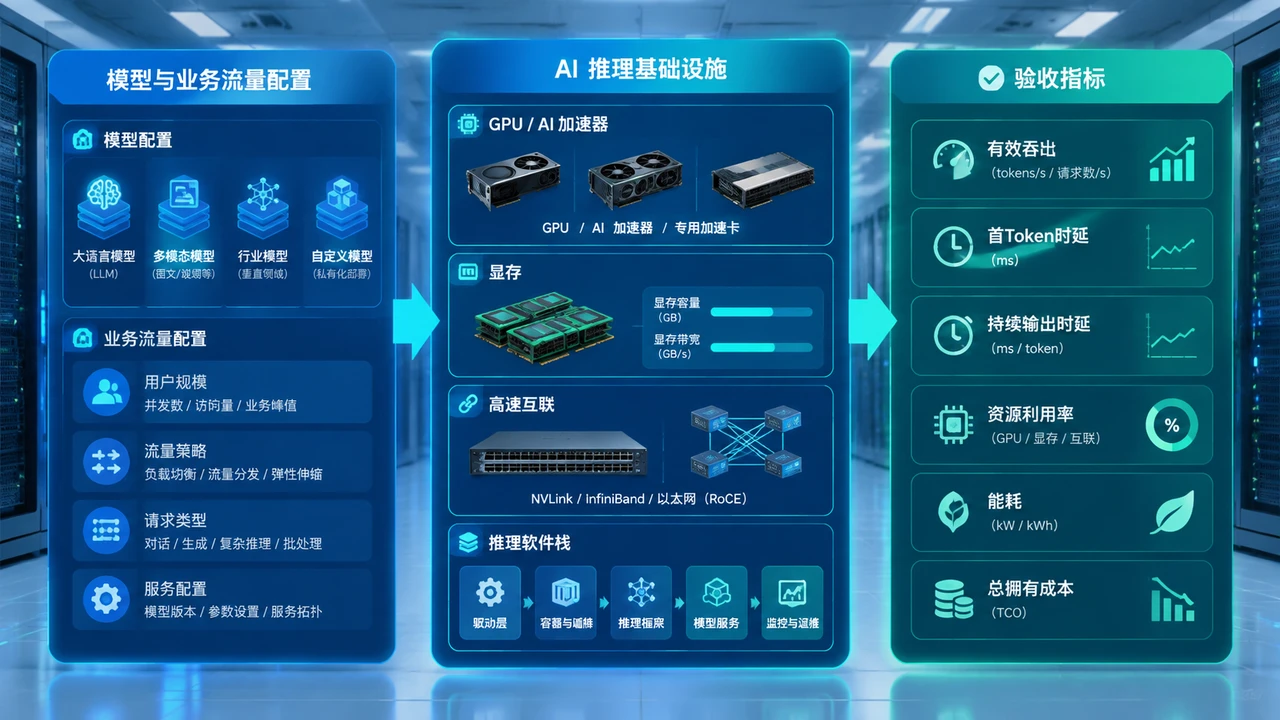
采购 AI 推理基础设施时,真正需要验收的不是芯片标称峰值,而是在指定模型、并发量、输入输出长度和服务等级目标下,系统能否稳定地产出可用 Token,并把时延、资源利用率、能耗、软……
王思涵-智讯整理官2026-09-11 21:17阅读 236
智能体 AI 的服务器选型,正在从“购买多少算力”转向“如何让一条任务链高效运行”。一个智能体请求通常同时包含模型调用、长上下文处理、检索、工具访问、权限控制、结果校验和多轮重试,……
王思涵-智讯整理官2026-09-11 20:54阅读 601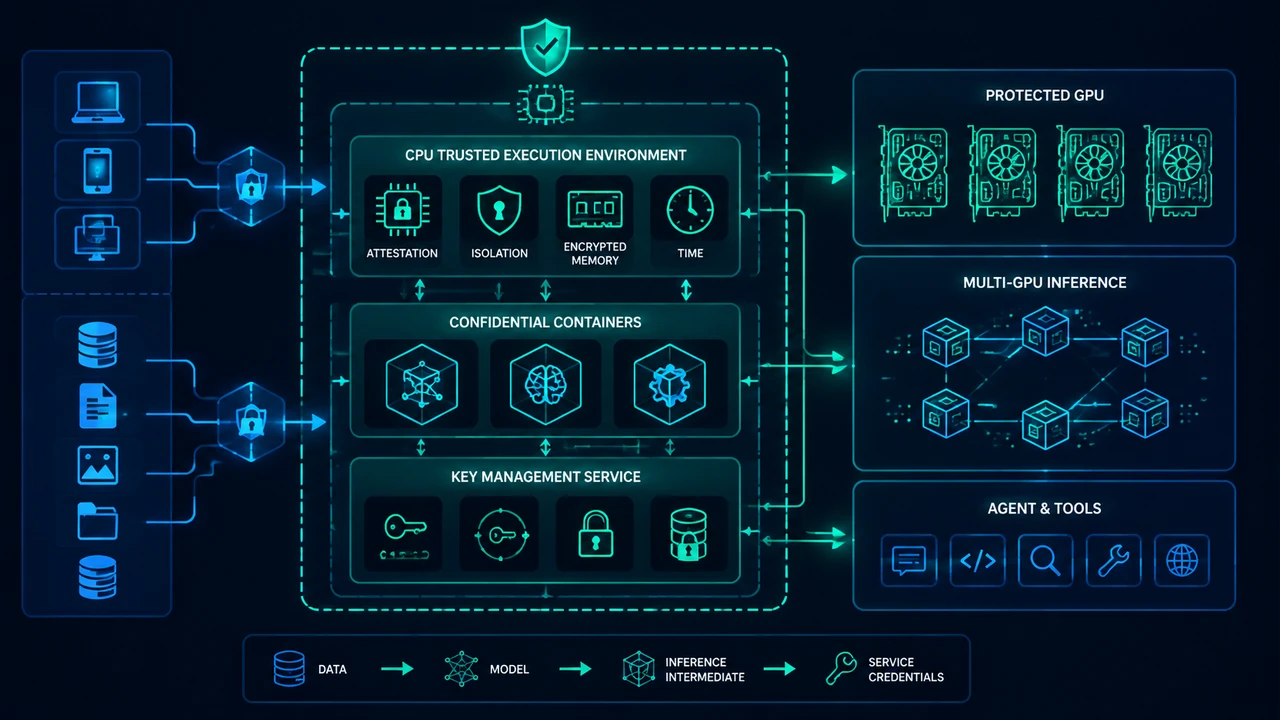
企业把大模型接入内部知识库、业务系统和自动化工具后,保护对象已经不只是“上传的数据”。用户输入、检索结果、模型权重、推理中间态、长期记忆、服务凭证以及智能体执行动作,都可能进入同一……
张晓峰-前沿探员2026-09-11 19:50阅读 400
当 AI 从演示走向生产,问题通常不再是“模型能不能运行”,而是“这次推理应该在哪里运行”。云端拥有更大的模型和更集中的算力,边缘节点更接近数据源,终端则能够在断网或高敏感场景下保……
李明哲-热点捕手2026-09-11 18:35阅读 262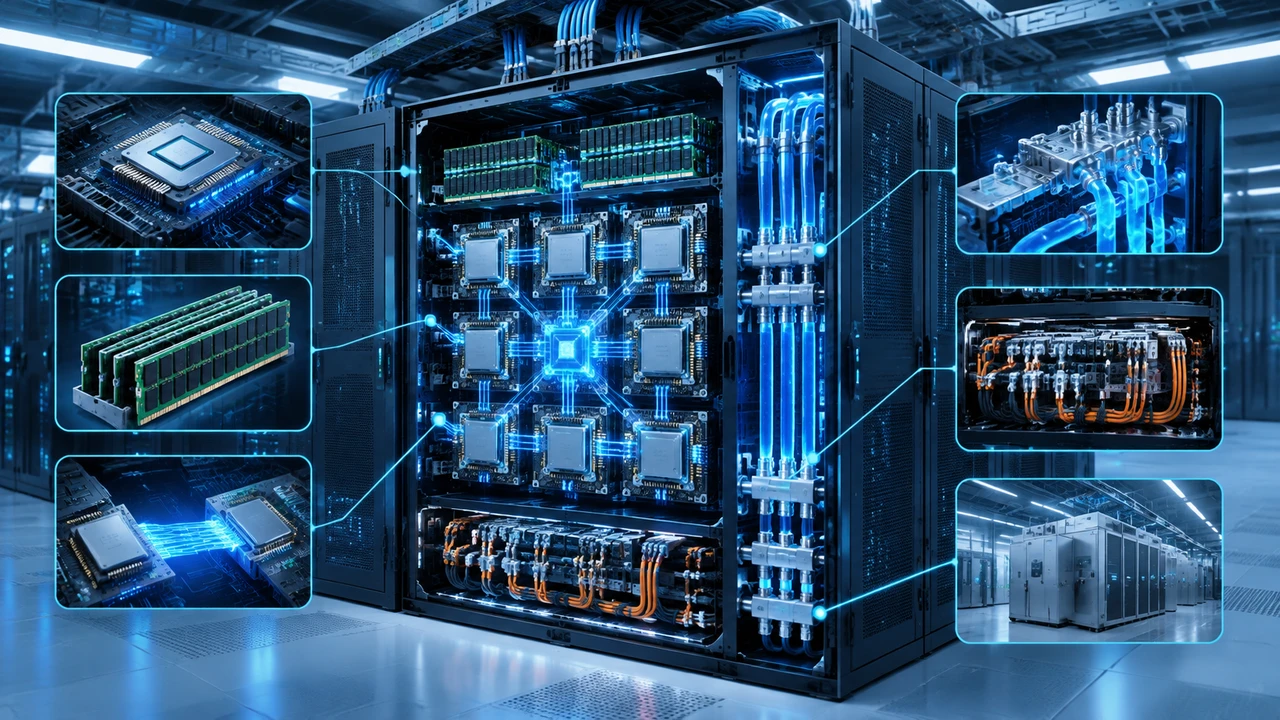
对企业而言,超节点不是“把更多加速卡装进一个机柜”这么简单,而是把多个计算芯片、内存、互联网络、软件栈和散热供电系统组织成一个更紧密的计算域。采购决策的关键,也不应停留在芯片数量或……
张晓峰-前沿探员2026-09-11 17:42阅读 481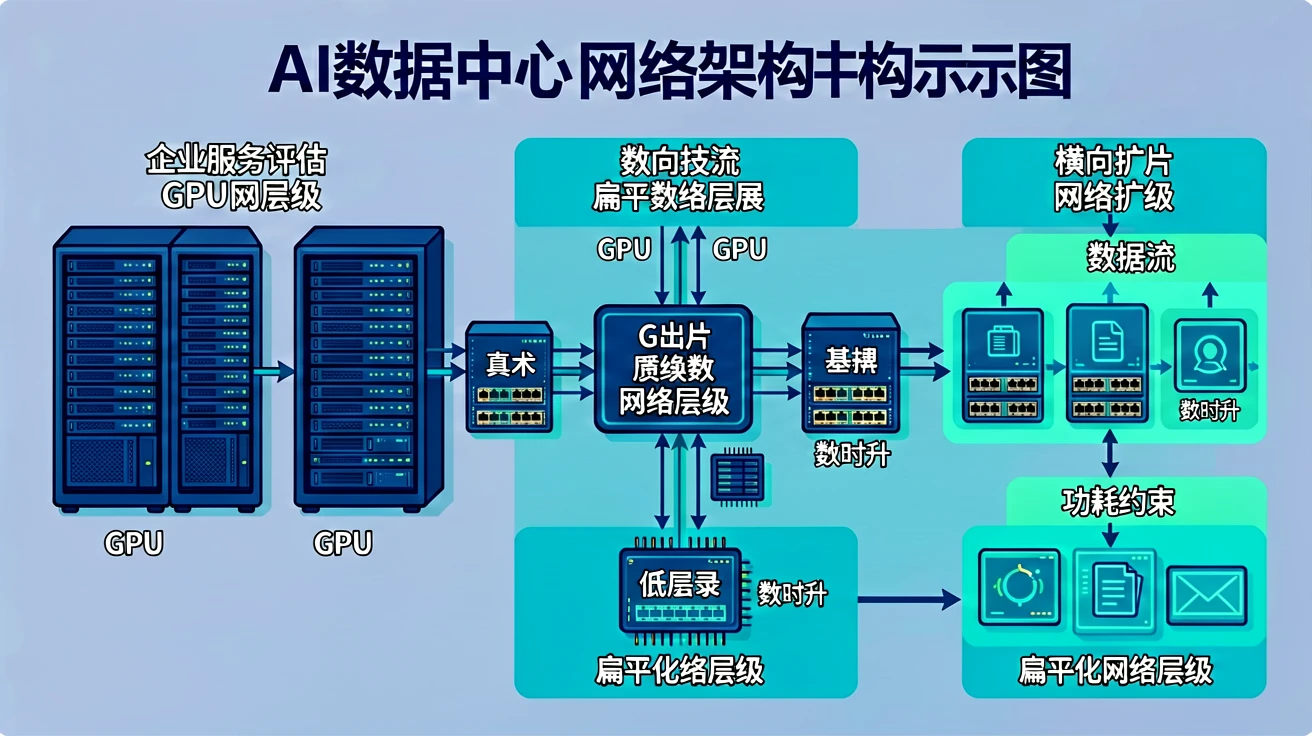
AI集群的瓶颈不一定来自 GPU 数量,也可能来自 GPU 之间交换数据的网络。随着训练任务扩大,参数同步、集合通信和推理请求会产生更高的东西向流量;如果交换网络存在带宽不足、拥塞……
张晓峰-前沿探员2026-09-11 17:03阅读 216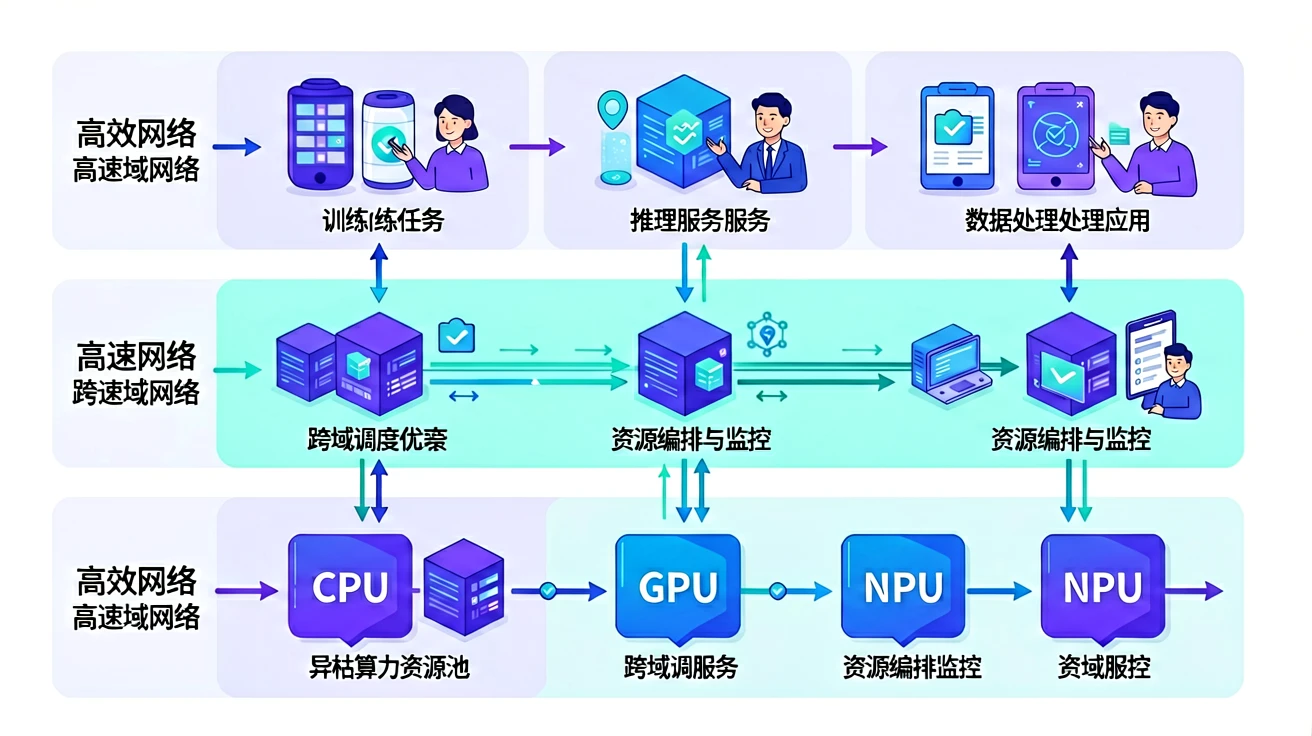
企业采购智能算力,真正需要回答的通常不是“要买多少张卡”,而是“一个训练、推理或数据处理任务,能否在指定时间内稳定完成,并且成本可解释、结果可复现”。中国信通院《智能算力服务研究报……
王思涵-智讯整理官2026-09-11 15:49阅读 194