推理成本
-
2026年9月16日AI新闻速递:大模型发布、融资与企业合作概览
面对缺乏可核验具体事件的当日AI新闻,企业若只追逐模型发布、融资和签约,很容易把市场热度误判为真实价值。文章提供一套更稳健的观察框架:从能力、调用成本、稳定性与安全部署评估模型,结合资金用途、客户留存和生态兼容性判断融资,并核验合作能否落到接口、SLA与售后交付,企业该如何用实测和成本测算做出决策?
-
AI新闻里的API价格调整如何影响企业选型:从标价变化到实际成本核算
AI模型API价格新闻若只盯着每百万Token标价,企业很容易误判真实成本:输入输出占比、缓存命中、输出长度、峰谷时段、套餐承诺、重试与人工复核都会改变账单。文章提供从调用结构核算“单位有效结果成本”的方法,并提醒迁移还要计入工程适配、质量验证与风险控制。面对涨跌,企业应如何避免被单一价格牵着走?
-
多模态模型落地不只靠更大参数:数据对齐与评测体系如何决定效果?
多模态模型从演示走向真实业务,难点并不只是堆叠参数:公开榜单上的高分,可能经不起模糊、遮挡、歧义数据的检验。数据对齐的粒度与质量、贴近业务的场景化评测,以及推理成本和任务适配,才决定方案能否落地。企业该如何用自有数据和小范围试点,找到效果与成本的平衡?
-
AI模型上下文窗口持续扩展:企业采购如何核算长文档处理的真实成本?
上下文窗口变长,真的能让企业更省钱、更准确吗?长文档处理的成本并不只看每百万令牌价格,还涉及输入输出、检索重排、重试、响应速度与人工复核。文章建议用真实业务测试集,分层验证定位、归纳、比较和推理能力,并综合准确性、完整性、稳定性、效率及数据安全,按任务总成本选择长上下文或检索、规则等方案。
-
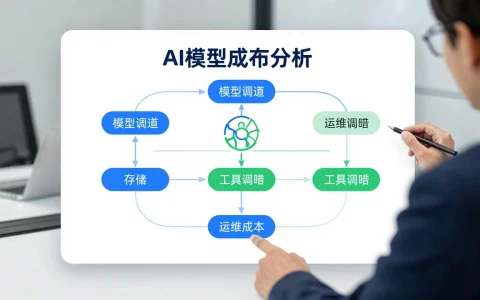
AI推理成本进入企业选型账本:模型价格之外还要核对哪些费用?
模型单价下降,企业AI成本却未必下降:一次请求可能牵动长上下文、检索存储、工具调用、重试、并发资源、运维治理与人工校验,单看每百万Token价格,容易低估长尾支出。文章拆解企业选型需核对的六类费用,并提出以“单任务有效成本”衡量最终产出:如何判断AI带来的效率,是否真正覆盖完整服务成本?
-
2026年AI大模型企业动态:国产开源、制造业落地与算力效率成选型新变量
大模型选型正在告别只看参数、价格和榜单的阶段:国产开源模型成为可验证的第二选择,制造业价值开始深入工艺参数,推理成本、延迟、功耗与边缘部署则成为硬约束。本文从许可协议、内部基准复现、数据基础和模型—硬件—推理框架协同出发,梳理企业如何区分宣传口径与可执行事实,找到真正算得清账、落得了地的方案?
-
2026 AI指数报告显示中美大模型竞争激化,企业应关注模型选型与专利布局
中美顶尖大模型的性能差距已收窄至2.7%,但美国在私营投资规模上仍领先中国约23倍。这种投入与能力之间的高度不对称,意味着模型性能已不再是企业的长期护城河,且领先权频繁易手导致选型稳定性下降。面对能力分布“锯齿状”且前沿模型由产业界主导的现状,企业应如何通过构建多模型架构、建立场景评测集及前瞻性专利布局,在激烈的竞争中化解技术不确定性?
-
光明日报:大模型竞争进入“能力+成本”阶段,企业选型为何不能只看效果?
大模型竞争已从单一效果比拼转向能力、成本、稳定性与治理能力的综合较量。企业选型若只看排名和单价,可能忽略长上下文、多轮调用、工具使用及失败重试带来的真实开销。文章提出以单位任务核算成本,并从效果、成本、稳定性、数据安全和供应商可控性五维评估,企业如何避免“模型买得好、系统用不起”?
-
9月12日AI新闻筛选指南:企业如何从模型发布、智能体落地与算力变化中识别有效信号
企业面对AI新闻,最怕把标题热度误当成可落地方案:模型性能、智能体接口和展会演示,必须分别核验可用状态、许可证、成本与交付证据。文章以DeepSeek V4.1-Flash、OpenAI Agents API及沈阳全球工业互联网大会为例,给出从新闻事实到企业行动的过滤清单;面对开放权重、接口开放消息和场景展示,企业该如何决定测试、试点还是观望?
-
智能体进入规模化落地临界点:模型、工具协议与企业治理谁在补齐最后一环?
智能体正从会聊天的工具走向真正接管业务系统的执行单元,但“连接能力增长”并不等于“产业成熟”。模型推理、协议标准化、企业治理与成本核算四重条件正汇聚成规模化落地的临界点,而MCP与A2A标准化的背后,治理却跟不上连接速度。多数企业仍停留在试点阶段,究竟是谁在拖慢智能体走向生产的最后一环?
-
中国模型占开源平台下载量41%:开源路线如何重塑AI产业竞争
中国模型在某国际开源平台大模型下载量中占41%,首次超过美国模型,但下载热度并不等于收入、生产部署规模或性能排名。文章拆解开源生态的竞争逻辑,并从能力、成本、社区、许可证与服务保障四方面,提示企业如何把关注度转化为可验证、可替换、可审计的生产选择,41%究竟意味着什么?
-
DeepSeek V4.1 Flash发布:原生视觉、MoE与KV缓存如何影响企业模型选型
DeepSeek V4.1 Flash采用原生视觉与MoE架构,输入、输出阶段分别激活约80亿和160亿参数,并以较小KV缓存支持长上下文与高并发。企业选型不能只看5520亿总参数,还应综合权重显存、专家通信、视觉输入、缓存管理及端到端成本,在目标硬件和业务负载下实测。