智能体应用
-
DeepSeek V4 Flash 词元定价降至每百万0.5元:成本竞争新格局
DeepSeek V4 Flash的成本优势主要来自缓存命中输入每百万词元0.02元,但缓存未命中输入为1元、输出为2元,“每百万0.5元”并非统一单价。团队应结合缓存命中率、输入输出量和调用流程评估真实成本,并通过任务分流与工程优化控制预算。
-
高校迎新开始使用AI智能体:校园应用如何从问答走向流程服务
高校正将AI智能体用于迎新咨询、校园导航和选课建议,推动校园服务从信息问答走向流程协作。文章指出,应用关键在于可靠知识库、持续更新的数据与清晰的责任边界,并应保留核验、人工转接和用户确认机制。
-
Gemini 3.8 Flash单任务成本上升四成:大模型价格战为何转向真实用量
Gemini3.8Flash任务成本0.58美元,较Gemini3.7Flash的0.40美元涨四成,因输出词元增30%且交互轮次增多。单价不变并不等于账单下降,企业应以任务级词元消耗和业务效果评估模型,而非仅看每百万词元标价。
-
Meta发布Muse Spark 1.3:低价与快速迭代能否撬动模型市场
Meta发布Muse Spark 1.3,主攻编程与AI智能体任务,支持最长约100万Token上下文,并通过减少工具调用和Token消耗降低多步骤任务成本。评测成绩受配置和任务影响,企业仍应以真实工作流验证成本与稳定性。
-
腾讯WorkBuddy开放平台接入超百家伙伴:办公智能体争夺进入生态阶段
腾讯WorkBuddy开放平台于9月2日上线,首批已有超过100家生态伙伴参与共创,30多个品牌完成连接并亮相9款联名智能硬件,覆盖软硬件、行业应用和开发者。文章分析办公Agent如何从模型与功能竞争转向真实任务、入口和生态协同。
-
词元经济受到关注:数据要素价值释放如何影响AI产业的商业逻辑
“词元经济”提供了观察AI商业逻辑的新视角,但词元不等同于数据价值,也不代表统一价格。数据开放、高质量数据集、治理与安全,决定数据能否进入模型训练、检索和应用。AI创业者应重视场景适配、数据质量与单位经济,数据产业则需建设可调用、可追溯、持续更新的数据产品。
-
算力产品密集涨价背后:AI供需博弈如何传导到企业应用成本
AI算力、存储和模型服务调价,正将云市场从资源价格竞争推向服务成本重估。需求增长、硬件基础设施成本上升及智能体多轮调用,使成本传导至推理、存储和数据处理。企业需按完整任务核算单位成本,优化模型与采购策略。
-
“AGI已经到来”能否直接转化为商业价值:Astra应用叙事的证据边界
AGI已到来并不等同商业价值,Astra虽具推理、跨应用操作和任务执行能力,但企业需验证其在真实环境中的稳定性、权限安全和错误可控性,先从可量化、可回滚的低风险场景试点,再评估任务完成率与人工复核成本,才能决定是否产生实际效益。
-
Meta同步推出实时多语言转录模型:语音AI竞争进入组合能力比拼
Meta推出Muse Voice Transcribe,支持实时流式语音识别、20多位说话者归属和端点检测,面向会议、客服及语音智能体等场景。文章分析其如何连接转录、通用模型与业务执行,并指出复杂环境仍需验证、纠错和人工复核。
-
五个月推出四款Muse Spark:AI模型更新为何越来越像产品迭代
五个月连续推出四款 Muse Spark,显示大模型竞争正从单次发布转向模型、接口与应用入口的持续迭代。以 1.3 的 DeepSWE 成绩提升 16 分为例,强调基准成绩不等于真实可用性,企业还需评估开放状态、接口稳定性和迁移风险。
-
Meta发布Muse Spark 1.3:代码与智能体能力成为本轮升级重点
Meta于9月2日发布Muse Spark 1.3,升级重点转向代码与智能体长任务,强调持续上下文、工具调用、计划修正和主动澄清;相较1.2,内部比较显示工具调用约减少20%、令牌使用量约减少25%,并支持一百万令牌上下文,同时接入Muse Code与Meta Model API。
-
从端侧小模型到293B基座:科大讯飞星火X2.5的产品布局怎么看
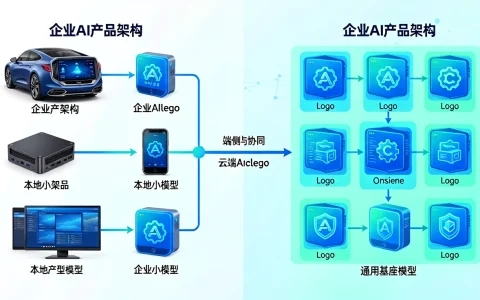
科大讯飞星火X2.5以端侧小模型与293B基座模型构成分层布局:1.7B和4B面向车载、智能硬件等本地交互,原生支持最长100万Token上下文;293B-A30B面向云端开发与企业应用,强化代码、智能体等能力。