AI编程工具
-
AI编程代理“技能”更新机制被曝可劫持:企业开发环境如何做供应链安全排查?
AI编程代理的“技能”更新链路,可能因不可信仓库、篡改包或自动更新成为新的供应链入口,并借助代理权限影响本地开发环境。文章提醒企业不要据此断言所有产品失陷,而应盘点来源与版本,核验哈希和签名,限制目录、凭据及网络访问,监控异常行为;面对这类会改变代理决策路径的风险,如何建立可回滚、可审计的受控更新机制?
-
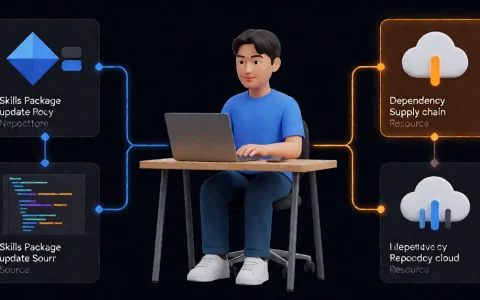
四大AI编程代理曝相同安全漏洞:“技能”更新机制遭劫持风险,企业如何防范?
当AI编程代理从代码补全工具变成能读取项目、执行命令、访问仓库和云资源的自动化协作者,“技能”更新也可能成为企业研发供应链的新入口:更新源被替换、依赖投毒、完整性校验缺失或权限过大,都可能诱发代码注入与凭据泄露。面对同时影响软件供应链和模型决策的风险,企业如何用资产清单、签名校验、版本审核、最小权限与运行时监控筑起防线?
-
从金融模型到编程模型:垂直场景正在成为大模型发布的新主线吗?
文章指出,大模型竞争正从通用能力和统一榜单转向场景适配:金融重可信、合规与审计,编程重代码执行、工具协同和迭代,智能体重任务闭环、稳定性与总成本。模型价值取决于能否融入真实业务流程,而非单项测试排名。
-
GLM-5.3与GLM-5.3-Flash接连受到关注,开源模型竞争正在转向编码和智能体能力吗?
GLM-5.3聚焦复杂编程、长程任务和智能体执行,GLM-5.3-Flash则突出原生多模态、视觉编程与低成本交互。两款模型表明,开源竞争正从参数规模转向软件工程、工具调用和真实任务交付,选型应依据任务复杂度与开发场景。
-
Gemini 3.7 Flash面向编程与智能体场景推出,低价策略会改变开发者选型吗?
谷歌推出 Gemini 3.7 Flash,聚焦编程、软件开发、知识工作与 AI 智能体,并接入 Gemini Spark。其 API 在 2026 年底前首发价为输入每百万 0.75 美元、输出每百万 3.75 美元,但选型仍应综合任务效果、调用结构、长期成本、安全与人工复核。
-
AI编程模型能力提升,软件团队为何更需要明确任务拆分与验收标准
【软盟资讯·新闻导读】AI编程模型和智能体工具持续增强,软件团队的瓶颈正在从“能不能写代码”转向“任务是否清楚、过程是否可控、结果由谁验收”。模型越能自主行动,研发管理者越需要把需求拆细,把责任链补齐。 最近一段时间,AI编程模型与相关工具…
-
长上下文成为AI编程新变量:大型代码库接入模型前要核对什么
【软盟资讯·新闻导读】长上下文正在改变 AI 编程处理大型代码库的方式。对维护复杂项目的团队而言,接入模型前,真正要核对的并不只是模型能否生成代码,而是上下文覆盖、仓库结构、代码保密与输出验证能否形成闭环。 9月9日,围绕 AI 编程工具形…
-
AI编程工具密集更新后,开发团队如何重设代码审查与调试流程
【软盟资讯·新闻导读】AI编程助手正从补全代码走向生成改动、分析报错和协助推理。工具能力提升并不意味着审查环节可以缩减,研发团队更需要重新划分机器处理与人工负责的边界。 近期围绕AI编程工具的讨论,已经不再只聚焦“能否更快写出一段代码”。越…
-
AI编程工具生态升级:2026年9月新发布的五大工具速览
AI编程工具已从单行补全转向任务协作,IntelliJIDEA2026.1集成Java,Flexpilot隐私,VisualStudioCopilot支持多步骤开发,Cursor全库上下文,选型应依据团队对工作流改动和隐私需求。
-
OpenRouter 报告:词元经济学如何重塑大模型定价策略
文章分析词元经济如何改变大模型定价与采购:不能只看每百万词元单价,还要核算输入、输出、上下文、重试及多轮调用的任务总成本。以DeepSeek V4 Flash为例,因缺少官方价格和性能资料,应结合真实任务测试、质量与人工修订成本审慎评估。
-
Claude Opus 4.6 与 4.8 对比评测:编程智能体的性能与可靠性
在AI编程工具的实际选型中,模型名称的更新并不等于开发体验会在所有任务上同步改善。围绕Claude Opus 4.6与Claude Opus 4.8的公开资料显示,4.8在多个共享基准上取得领先,但两款模型在SWE-Bench Pro、逻辑…
-
Qwen3-32B 在代码生成中的突破:多语言支持与低延迟实测
文章梳理了 Qwen3-32B 在代码生成中的能力边界:相较 Qwen-2.5-32B-Instruct,其更强调复杂问题理解、多步推理和任务适应性;“支持200余种语言”、低首字延迟与高吞吐量尚缺乏可核验的专项实测,团队应通过生成、修复、迁移及性能测试评估。