AI算力集群在进行大规模模型训练和实时推理时,对底层网络的性能要求达到了前所未有的水平。传统的IP网络在面对高流量突发时容易出现拥塞,导致数据包丢失,这不仅浪费带宽资源,还会使计算资源(如GPU)处于闲置状态,从而无法将算力转化为实际的业务价值。无损网络技术正是为了解决这一问题,通过确保数据包不丢失的方式,让网络性能真正转化为有效算力。
拥塞控制:保障算力利用率的关键
AI集群中节点间通信如AllReduce操作对网络延迟和丢包极为敏感。拥塞控制机制如Priority Flow Control(PFC)和Explicit Congestion Notification(ECN)能快速响应链路拥塞,避免下游节点因上游阻塞而等待。相比TCP的基于窗口的拥塞控制,无损网络提供了更确定性的性能,确保即使在高负载下也不会因重传而浪费算力。企业评估时需关注算法效率:RoCE v2结合ECN和PFC能够在链路层毫秒级响应,而非依赖上层重传,这直接关系到GPU利用率能否从典型60-70%提升至90%以上。
网络拓扑与故障域隔离
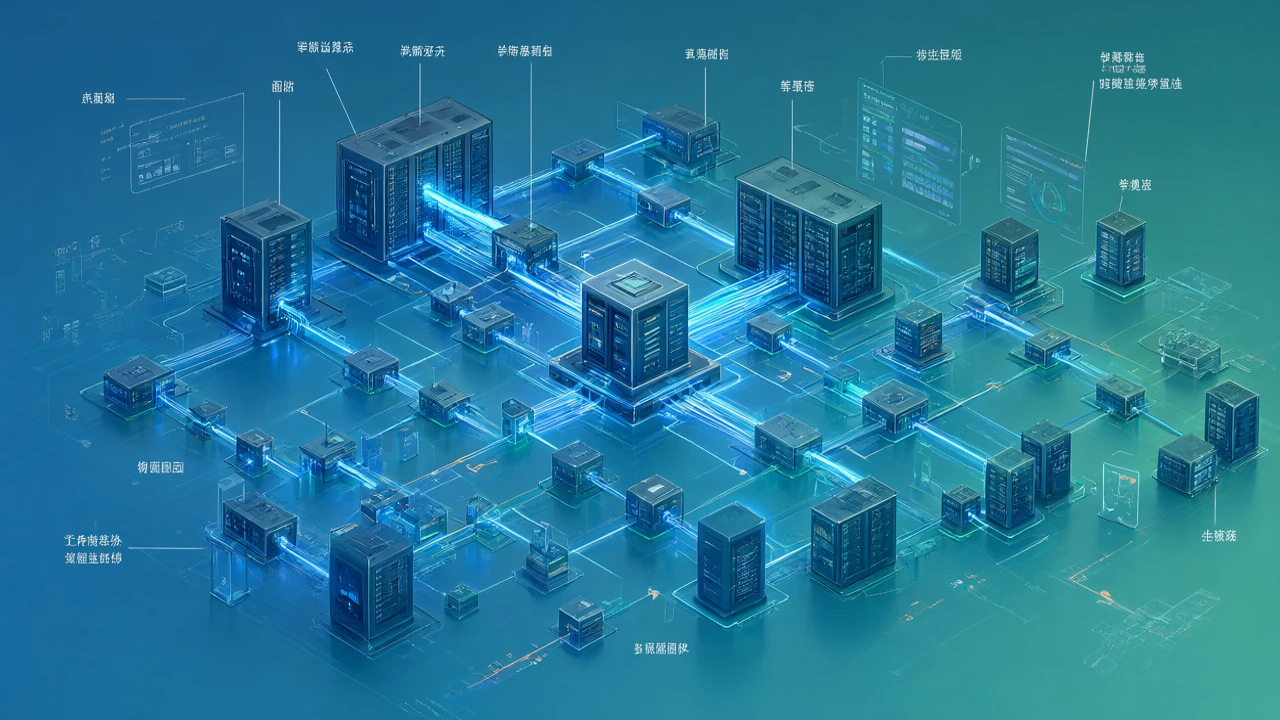
叶-脊叶(Leaf-Spine)架构是AI集群常用的网络拓扑选择,它天然支持高带宽低延迟,并通过虚拟路由冗余协议(VRRP)实现故障检测和隔离。一旦交换机或链路出现问题,网络应能在毫秒级内切换,避免整个集群停滞。企业验收框架中,故障域隔离是核心指标:需验证单故障域(如单个交换机故障)对整体训练收敛速度的影响,避免因为拓扑设计缺陷导致部分节点长期无法参与计算。
有效吞吐与尾延迟:性能评估的核心指标
网络性能是否真正转化为有效算力,关键看有效吞吐(goodput)和尾延迟。有效吞吐是扣除开销和重传后的实际数据传输率,而尾延迟是统计99.9%或更高分位数下的最大延迟。对于AI训练,尾延迟的提升能显著缩短迭代周期。企业应使用专用基准测试工具(如NVIDIA NCCL测试或SNDlib)来测量这些指标,并设定验收门槛:有效吞吐目标达到峰值带宽的95%以上,尾延迟控制在特定毫秒数内。
兼容性与成本权衡
选型时需评估兼容性:网络设备是否与现有InfiniBand或RoCE适配器无缝集成,以及是否支持多种AI框架和存储系统。成本方面,虽然无损网络设备价格较高,但若能将算力利用率显著提升,其总拥有成本(TCO)往往更优。企业需计算包括网络维护、升级和技能培养在内的全面投入,避免单纯购买高规格设备而忽视长期运营开销。
运维复杂度:从技术到组织层面
无损网络的运维要求更高,需要具备网络编程、自动化工具(如Ansible或Kubernetes网络策略)和故障演练能力。企业不应简单购买高规格设备,而是通过内部培训或外包服务确保团队能高效管理。风险提示是,如果忽略运维,网络问题会反噬算力性能,造成数据一致性隐患或训练中断。
企业选型与验收框架
基于上述分析,企业可从以下六个维度建立选型与验收框架:有效吞吐(通过模拟负载测试,目标达到峰值带宽的95%以上)、尾延迟(验收指标设定在特定毫秒数内)、故障域(验证单故障域隔离时间)、兼容性(与服务器、存储和AI软件的互操作性)、成本(TCO计算,考虑长期运维)和运维能力(团队技能评估和支持SLA)。通过这些指标,企业能避免将高规格网络设备单纯当成算力性能的替代品,而是从实际业务场景出发进行架构升级。
相关话题
关于文章版权的声明:
https://news.softunis.com/80838.html 文章来自软盟资讯
若非本站原创的文章,特别作如下声明:
本文刊载所有内容仅供提供信息交流和业务探讨而非提供法律建议目的使用,不代表任何监管机构的立场和观点。不承担任何由于内容的合法性及真实性所引起的争议和法律责任。
凡注明为其他媒体来源的信息,均为转载,版权归版权所有人所有。
如有未注明作者及出处的文章和资料等素材,请版权所有者联系我们,我们将及时补上或者删除,共同建设自媒体信息平台,感谢你的支持!