很多企业在规划数字孪生项目时,往往先被“数字孪生”这个概念吸引,随后自然联想到要上云计算、接物联网、用人工智能。但技术组合本身不是目标,业务目标才是。一个常见的误区是:先把云、边、端的数据管道铺好,把大模型或机器学习框架部署上去,再回头想这些能力到底要解决什么问题。结果平台建得很完整,业务部门却用不起来。
更务实的做法,是从业务目标反推技术组合。你先要回答:这个数字孪生系统,最终要支撑什么决策?是让现场操作员更快发现问题,还是让管理层在季度复盘时看清产能瓶颈?不同的目标,决定了数据该在哪里处理、模型该在哪里运行、哪些能力必须放在边缘,哪些放在云端,哪些干脆留在现有业务系统里就够了。
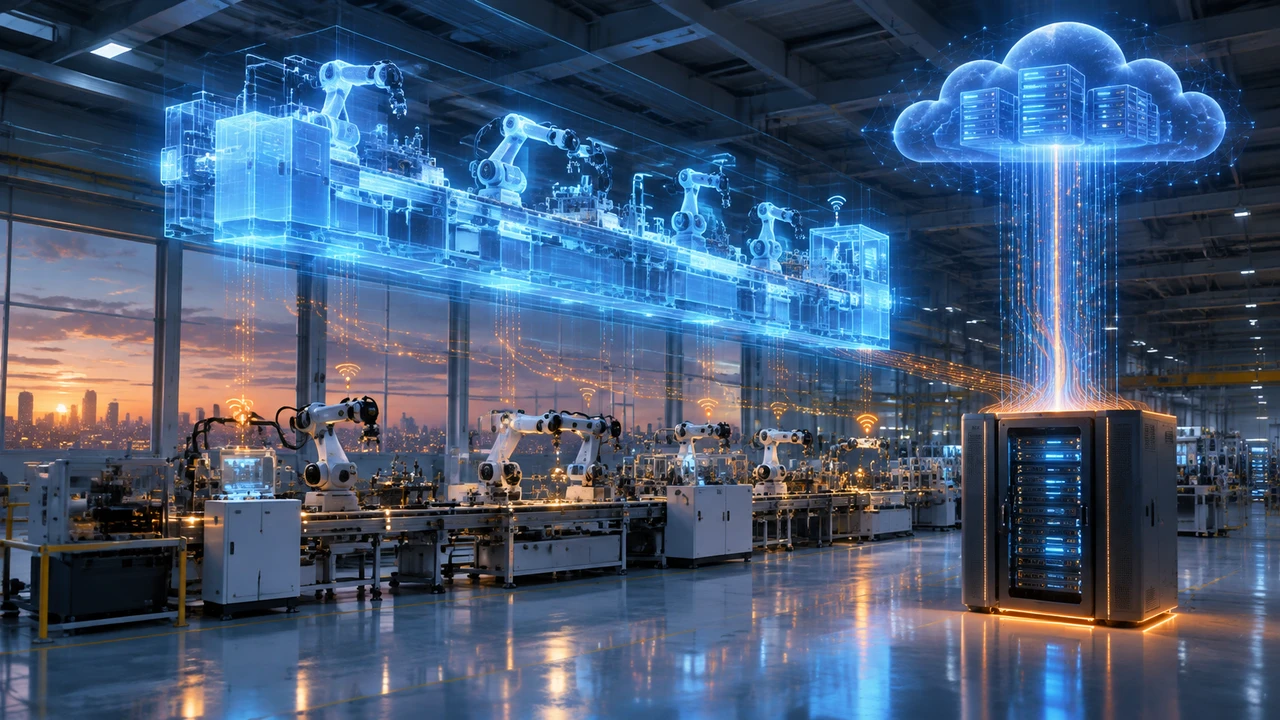
围绕这个判断逻辑,数字孪生与云计算、物联网、人工智能的协同关系,可以拆成四个具体的判断点来看。
判断点一:数据采集的实时性要求,决定物联网的部署深度
物联网在数字孪生体系里的职责,是解决“数据从哪来”的问题。但物联网的部署深度,并不取决于设备本身是否智能,而取决于业务对数据时效性的容忍度。
如果你的场景是设备预测性维护,振动、温度、电流这类高频数据需要以秒级甚至毫秒级频率采集,那么边缘侧的物联网网关就必须具备初步的数据清洗和缓存能力,否则海量原始数据直接上云,网络带宽和存储成本会迅速失控。反之,如果你的场景是园区能耗分析,采集频率可能只需要分钟级甚至小时级,那么物联网设备可以做得更薄,数据直接汇聚到云端处理即可。
这里有一个容易被忽略的细节:数据采集的实时性,不等于数据处理的实时性。很多企业把“实时采集”和“实时决策”混为一谈,结果在边缘侧部署了大量算力,实际业务却根本不需要那么快的反馈。判断的标准很简单——从数据产生到业务动作发生,中间允许的延迟是多少?如果允许几十秒,云端处理就够了;如果必须在一两秒内响应,才需要考虑边缘计算。
判断点二:模型计算的复杂度,决定人工智能放在哪一层
人工智能在数字孪生中的角色,是把数据变成判断。但AI模型放在哪个层级运行,取决于模型的复杂度、更新频率和推理延迟要求。
对于需要高频推理的轻量模型,比如设备异常检测中的分类模型,模型体积小、推理速度快,适合部署在边缘侧或网关层,直接在数据源头附近完成判断,只把异常结果和摘要数据上传云端。这样做的好处是响应快、带宽省,而且即使网络中断,现场判断能力依然可用。
对于需要全局优化的复杂模型,比如整个工厂的排产优化、供应链的全局预测,这类模型依赖跨系统、跨产线的全局数据,计算量大、训练周期长,更适合放在云端,利用云计算提供的弹性算力进行训练和定期更新。云端模型推理出的结果,再下发给边缘侧执行。
这里要特别提醒一个误区:并非模型越复杂越好。很多企业在数字孪生项目里强行引入深度学习模型,但业务场景的数据量根本不足以支撑训练,或者传统的机理模型、统计模型已经能解决90%的问题。人工智能的选型原则应该是“够用就好”,而不是“越先进越好”。在判断AI应该放在哪一层之前,先判断这个场景到底需不需要AI。
判断点三:实时交互与协同的需求,决定云边端的职责边界
数字孪生区别于传统仿真软件的一个重要特征,是它的“活”属性——孪生体与物理实体之间是持续双向互动的。这种互动需求,直接决定了云、边、端各自的职责。
如果你的数字孪生主要用于可视化展示和离线分析,比如让管理层在驾驶舱里查看产线运行状态、回放历史故障过程,那么云端负责数据汇聚、模型计算和渲染即可,交互延迟在秒级都是可以接受的。这种场景下,云端是核心,边缘侧只负责数据采集和上传。
但如果你的数字孪生要支撑现场操作员的实时作业,比如设备调试时操作员需要在孪生界面上操作,物理设备同步响应,那么交互延迟必须控制在毫秒级。这种情况下,边缘侧就必须承担起实时计算和本地渲染的职责,云端退居为模型训练、数据存储和全局协调的角色。此时如果所有计算都依赖云端,网络抖动一次,现场操作就会卡顿甚至失控。
判断云边端职责边界时,可以画一条线:哪些交互是现场必须即时响应的,哪些是可以容忍延迟的。前者放边缘,后者放云端。这条线画清楚了,架构自然就清晰了。
判断点四:安全隔离与数据主权,决定系统的物理边界
数字孪生系统涉及的数据,往往包含企业的核心工艺参数、设备运行数据、甚至客户隐私信息。这些数据放在哪里、由谁管理、如何隔离,不仅是技术问题,更是合规问题。
如果你的数字孪生系统只服务于单一工厂内部,数据不出厂区,那么可以采用私有化部署,或者边缘侧为主的架构,云端仅作为可选的数据备份。如果你的系统需要跨地域协同,比如集团总部需要看到各个工厂的孪生数据,那么就需要考虑云端的集中管理,但此时必须做好数据分级——哪些数据可以上云,哪些数据只能留在本地。
安全隔离的另一个维度,是系统之间的隔离。数字孪生平台往往需要与企业现有的ERP、MES、SCADA等系统打通,但并不意味着所有系统都要物理接入同一个平台。更稳妥的做法是,数字孪生平台通过标准接口与业务系统交互,而不是直接读写业务系统的数据库。这样即使孪生平台出现问题,也不会影响核心业务系统的稳定运行。
四个判断点之外的提醒:什么时候不适合建数字孪生
以上四个判断点,回答的是“如何建”的问题。但还有一个更前置的问题值得每个企业认真思考:这个场景,真的需要数字孪生吗?
以下三种情况,通常不适合建设复杂的数字孪生平台:
业务目标不明确。 如果你的需求只是“把设备数据可视化”,那么一套BI工具加几个传感器就能解决,不需要搭建完整的数字孪生体系。数字孪生的价值在于持续的双向互动和预测能力,如果业务上不需要这种互动,投入产出比会非常难看。
数据基础太薄弱。 数字孪生的质量,取决于物理实体数据的完整性、准确性和连续性。如果企业现有的设备没有数字化改造,数据采集靠人工录入,那么再先进的技术架构也无法产出可靠的孪生模型。这种情况下,先补数据基础,比先建平台更紧迫。
组织能力跟不上。 数字孪生不是一次性的IT项目,而是需要持续运营的业务能力。它需要懂业务的工程师、懂数据的分析师、懂现场的操作员协同维护。如果企业没有相应的组织保障,平台建成之日就是闲置之时。
回到最初的判断逻辑:技术组合是手段,业务目标是目的。云计算提供弹性,物联网解决连接,人工智能赋予判断,数字孪生整合呈现——但这一切的前提,是你清楚地知道,你的业务到底需要什么样的“判断”。把这个问题想清楚了,技术选型自然水到渠成。
相关话题
关于文章版权的声明:
https://news.softunis.com/75695.html 文章来自软盟资讯
若非本站原创的文章,特别作如下声明:
本文刊载所有内容仅供提供信息交流和业务探讨而非提供法律建议目的使用,不代表任何监管机构的立场和观点。不承担任何由于内容的合法性及真实性所引起的争议和法律责任。
凡注明为其他媒体来源的信息,均为转载,版权归版权所有人所有。
如有未注明作者及出处的文章和资料等素材,请版权所有者联系我们,我们将及时补上或者删除,共同建设自媒体信息平台,感谢你的支持!