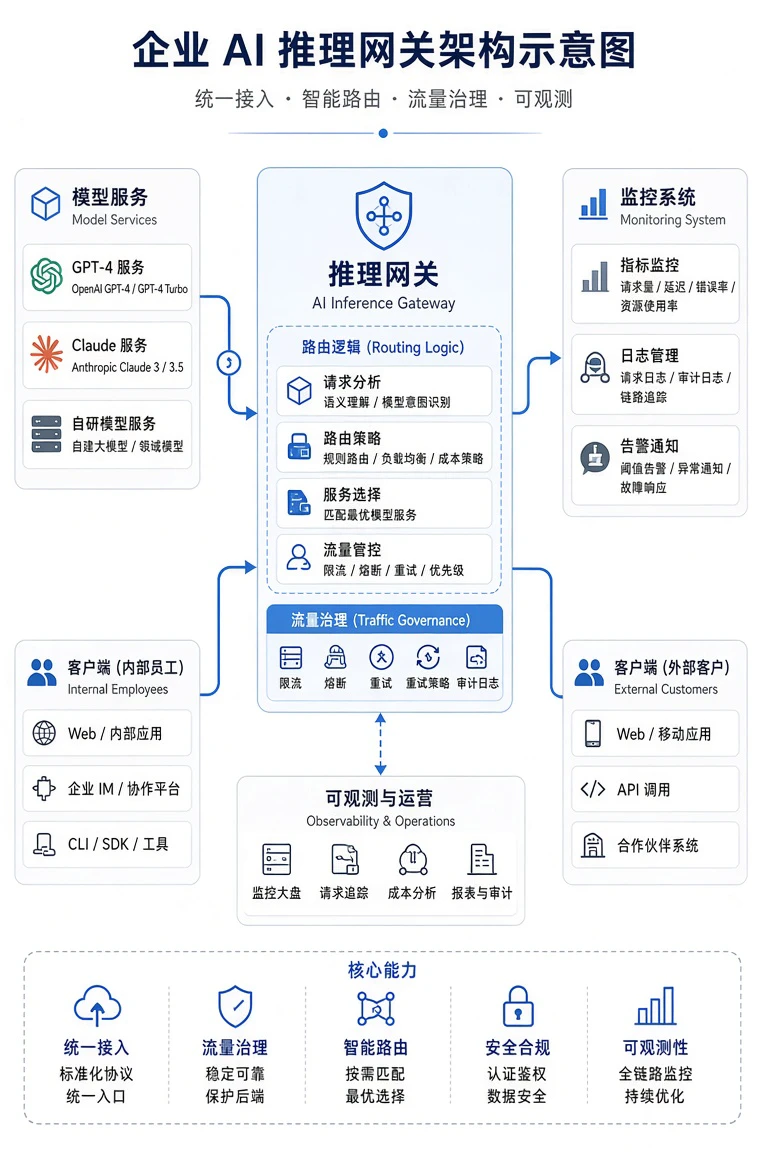
当企业将大模型从实验阶段推向生产环境,模型服务化就不再只是部署一个API端点那么简单。流量从四面八方涌来——内部员工、外部客户、不同业务线的多个模型——如果没有一个统一的流量治理层,很快就会陷入“谁在调用哪个模型、花了多少钱、有没有超限”的混沌状态。AI推理网关正是在这个节点上,从可选的中间件变成了企业架构中的关键组件。
它解决的核心问题有三个:路由的智能性与隔离性、流量的可控性与可观测性、成本与合规的归因能力。选型时,需要从这几个维度逐一拆解。
模型路由:从简单转发到语义感知
早期网关只做请求转发,根据URL路径把请求丢给对应的模型服务。但在AI推理场景里,路由逻辑远不止于此。一个典型的场景是,企业同时接入了GPT-4、Claude 3和自研的百亿参数模型,需求是:简单问答走自研模型以控制成本,复杂推理任务才调用GPT-4。这就考验网关是否具备基于请求内容或元数据的路由能力。
评估时重点看三点:第一,是否支持基于请求体(payload)中特定字段的路由,比如根据prompt长度或model参数做条件分发;第二,能否实现权重或优先级路由,比如灰度发布时把10%流量导向新模型版本;第三,是否具备模型回退(fallback)机制——当主模型超时或报错时,自动降级到次优模型,保证服务不中断。
需要警惕的是,一些网关宣称支持“语义路由”,实际上只是简单的关键词匹配。真正的语义路由需要网关能理解查询意图,这通常意味着它本身要嵌入一个小模型做分类,会额外增加延迟和成本,是否值得投入要看业务场景的复杂度。
限流与多租户隔离:不止是“每秒请求数”
生产环境中,不同租户或业务线共享同一组模型服务资源,如果没有精细化的限流,一个突发请求就可能挤占其他租户的算力。传统的令牌桶或漏桶算法在AI推理场景下需要扩展,因为模型推理的耗时差异极大——一个简单的文本分类可能10毫秒完成,而一个长文档摘要可能耗时数秒。
更合理的做法是基于并发数和请求队列深度进行限流,而非仅看QPS。同时,网关需要支持多维度限流:按API Key、按用户组、按模型、甚至按请求的输入Token数。例如,给VIP客户分配更高的并发上限,同时限制免费用户的每次输入长度不超过2048 tokens。
隔离性方面,部分高级网关支持模型实例级路由隔离,即不同租户的请求被强制路由到不同的推理副本上。这能避免“吵闹邻居”问题,但会牺牲资源池化带来的利用率。对于合规要求高的场景(如金融、医疗),这种硬件级隔离往往是硬性需求。
成本归因:把Token消耗“钉”到业务线
模型服务化的最大隐性成本不是GPU硬件,而是Token消耗。一个业务部门可能同时调用多个模型,如果不做精细化的成本拆分,月底财务看到的只是一笔笼统的API账单。AI推理网关在这里扮演成本计量与分摊枢纽的角色。
核心能力包括:按请求维度记录输入和输出Token数,并关联到调用方身份(API Key、项目ID);支持按模型单价实时计算每次调用的消耗成本;提供按时间、租户、模型、用户等多维度的成本聚合报表。更进一步,有些网关能设置预算告警——当某个租户的日消耗超过预设额度时,自动降级其服务等级或直接阻断。
选型时要注意,Token计数必须与模型供应商的计价口径一致。比如OpenAI的计费规则中,输入和输出Token价格不同,且部分模型对“prompt缓存命中”有折扣。网关如果只是粗暴地统计总Token数,算出来的成本会和实际账单对不上。
审计日志与合规边界:不可篡改的调用链
在金融、医疗等强监管行业,每一次模型调用都需要留下完整的审计轨迹:谁在什么时间调用了哪个模型,输入了哪些内容,输出了什么,以及模型返回的置信度或安全审核结果。AI推理网关天然处于请求链路的入口,是收集这些数据的最佳位置。
审计日志的关键要求是完整性、不可篡改性和时效性。网关需要记录请求和响应的完整体(或经哈希处理后的摘要),并支持将日志持久化到外部存储(如对象存储、日志平台)。部分场景下还需要支持“拒绝写入”——如果日志存储不可用,网关应拒绝请求而非静默跳过日志记录。
合规方面,数据驻留(data residency)是常见痛点。如果企业使用部署在特定区域的模型服务,网关必须确保请求不会因路由策略被错误转发到其他区域的模型实例。此外,对于输入数据中包含个人身份信息(PII)的请求,网关是否支持在审计日志中进行脱敏或掩码处理,也是合规审计的关注点。
落地清单:四个关键决策点
回到选型本身,没有通用的最优解,只有最适合当前架构的取舍。建议团队按以下顺序评估:
- 路由策略的复杂度:如果只有1-2个模型且调用方单一,Nginx或Kong配合简单插件即可满足;如果涉及多模型、多租户、语义路由和灰度发布,则需要专业的AI网关(如基于Envoy扩展的解决方案或专用AI代理)。
- 可观测性的深度:至少需要覆盖请求延迟、Token消耗、错误率三个核心指标。如果成本归因是硬需求,确保网关能输出按租户和模型维度的Token计量数据。
- 与现有基础设施的集成成本:网关是否兼容Kubernetes Ingress/ Gateway API,能否直接接入已有的监控系统(Prometheus、Grafana)和日志管道(Elasticsearch、Splunk),决定了运维团队的上手难度。
- 安全与合规的硬性约束:如果业务涉及跨境数据传输或强监管场景,优先考虑支持数据脱敏、请求审计和区域路由约束的网关,而不是后期通过外部组件打补丁。
AI推理网关不是万能药,但它能让模型服务化从“能跑”走向“可管”。在技术选型上,与其追求大而全的功能列表,不如先厘清当前架构中哪个痛点最迫切——是成本失控、租户干扰,还是审计缺失——然后选择最能解决这个问题的方案。
相关话题
关于文章版权的声明:
https://news.softunis.com/81440.html 文章来自软盟资讯
若非本站原创的文章,特别作如下声明:
本文刊载所有内容仅供提供信息交流和业务探讨而非提供法律建议目的使用,不代表任何监管机构的立场和观点。不承担任何由于内容的合法性及真实性所引起的争议和法律责任。
凡注明为其他媒体来源的信息,均为转载,版权归版权所有人所有。
如有未注明作者及出处的文章和资料等素材,请版权所有者联系我们,我们将及时补上或者删除,共同建设自媒体信息平台,感谢你的支持!