AI服务器功率密度持续攀升,已不再是“机柜里能不能塞下更多GPU”的问题,而是“数据中心能不能安全、稳定地供上电”。过去,一台标准42U机柜的功耗在3-5kW,而现在单台AI训练服务器的峰值功耗就可能达到10kW甚至更高,一个高密度机柜的功率需求轻松突破40kW。供电架构的选型,因此从设备兼容性评估,彻底转向了基础设施级的容量规划与风险管理。
功率密度决定了配电架构的起点
评估供电架构的第一步,是明确单机柜的功率密度目标。当前业界大致分为三个区间:10-20kW/柜属于中等密度,传统列头柜配电和风冷散热基本可以应对;20-40kW/柜属于高密度,必须引入母线配电和液冷方案;40kW/柜以上则属于超高密度,需要机柜级配电、行级或芯片级液冷,以及更精细的功率监控。
功率密度直接决定了机柜内PDU的选型。传统单相PDU的功率上限通常在3-5kW,高密度场景必须采用三相PDU,并配合智能功率管理功能,实时监测每路输出的电流和电压,避免单相过载。对于40kW以上的机柜,还需要考虑双路冗余供电,即每个机柜接入两路独立的配电母线,任何一路故障都不会导致服务器掉电。
冗余配置不是越多越好,而是取决于故障隔离粒度
供电冗余是可靠性保障的核心,但“2N”或“N+1”并非放之四海皆准。N+1配置(即一台UPS或一路配电冗余)适用于中等密度、单机柜故障影响可控的场景;而AI训练集群一旦中断,重新加载模型参数可能耗费数小时,因此2N冗余(完全双路独立供电)在核心训练集群中几乎是标配。
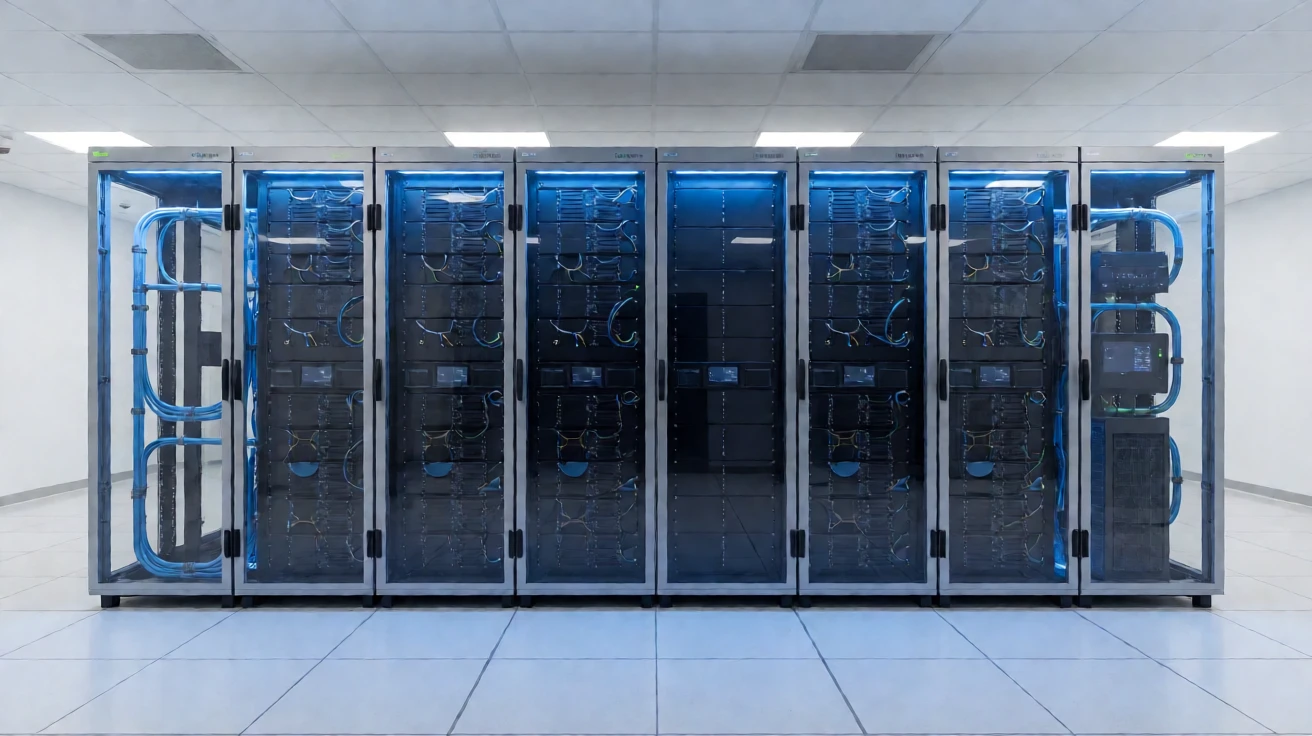
关键判断点在于故障隔离的粒度。如果采用集中式UPS(大型UPS为整个数据中心供电),一旦UPS故障或维护,整个机房都会受影响。更合理的做法是采用分布式UPS架构,将UPS部署在每一列机柜的列头或机柜内部,实现故障域隔离。这样,一台UPS故障只影响一列或一个机柜,不会波及整个集群。同样,配电柜和母线也应按列分区,避免单点故障扩散。
能效管理:从PUE到功率调度的精细化
供电架构选型不能只看可靠性,能效直接关系到运营成本。AI服务器的负载波动极大——训练任务启动时电流冲击可达稳态的1.5-2倍,而推理任务则呈现间歇性高负载。传统UPS的效率曲线在50%-80%负载区间最高,轻载或满载时效率下降明显。
因此,需要引入功率调度策略,而非简单堆砌UPS容量。一种常见做法是采用“UPS+电池直供”的混合架构:正常运行时由UPS供电并保持电池浮充,当检测到电网波动或负载剧烈变化时,电池瞬时介入,避免UPS频繁切换旁路。对于液冷场景,冷却泵和冷水机组的功耗也需要纳入配电规划,与服务器功率统一调度,避免出现“配电够但冷却跟不上”的窘境。
运维改造:存量数据中心如何适配AI负载
对于已投产的数据中心,供电架构改造往往比新建更具挑战。旧有配电系统通常按4-6kW/柜设计,母线容量和开关规格都偏小。直接升级机柜PDU和增容UPS可能引发上游变压器和低压配电柜的连锁改造。
可行的路径是分步实施:先对现有配电系统做一次全面的功率审计,标记出负载率低于60%的机柜列,将其改造为高密度区,通过调整三相平衡和更换智能PDU,将单柜功率提升至15-20kW。同时,在配电柜层面预留未来扩容的断路器位置,避免后续改造时重新布线。对于实在无法增容的老旧机柜,可采用“功率封顶”策略——通过BMC或PDU限制单台服务器的最大输入功率,确保总负载不超出上游开关额定值。
选型决策的核心:容量、弹性与成本的三角平衡
最终,供电架构选型没有标准答案,而是取决于业务规模与增长预期。对于部署10台以内AI服务器的企业,可以采用单路N+1 UPS加机柜级PDU的方案,投资适中、运维简单。对于部署50台以上训练服务器的场景,2N冗余、分布式UPS和液冷配电几乎是必选项,初始投资高但故障风险低。而对于计划未来12-18个月内扩容超100%的客户,建议在配电柜和母线选型时直接按峰值容量预留30%-50%的余量,避免后续二次改造。
供电架构的选型逻辑已经发生了根本转变:不再是“服务器能装进机柜就行”,而是“数据中心能不能稳定地喂饱这些功耗猛兽”。功率密度、冗余粒度、能效调度和改造弹性,这四个维度构成了技术负责人必须掌握的基本判断框架。
关于文章版权的声明:
https://news.softunis.com/81537.html 文章来自软盟资讯
若非本站原创的文章,特别作如下声明:
本文刊载所有内容仅供提供信息交流和业务探讨而非提供法律建议目的使用,不代表任何监管机构的立场和观点。不承担任何由于内容的合法性及真实性所引起的争议和法律责任。
凡注明为其他媒体来源的信息,均为转载,版权归版权所有人所有。
如有未注明作者及出处的文章和资料等素材,请版权所有者联系我们,我们将及时补上或者删除,共同建设自媒体信息平台,感谢你的支持!